Täglich treffen im Wareneingang unterschiedliche Lieferungen ein und jede bringt ihre eigenen Begleitpapiere mit. Die manuelle Dokumentation dieser Lieferscheine kostet Zeit und bindet Ressourcen. Um diesen Prozess effizienter zu gestalten, hat sich ein Medizingerätehersteller Unterstützung beim Mittelstand-Digital Zentrum Augsburg gesucht. Entstanden ist ein KI-Anwendungsprojekt, das die Dokumentenflut im Wareneingang nun digital und automatisiert bewältigt.

Medizintechnik aus Mammendorf

Die MIPM Mammendorfer Institut für Physik und Medizin GmbH ist ein 1982 gegründetes Familienunternehmen mit Sitz im oberbayerischen Mammendorf. Das rund 70-köpfige Team hat sich auf die Entwicklung und Herstellung von MRT-kompatiblen medizinischen Geräten wie Patientenmonitoren und Infusionssystemen spezialisiert. Diese Lösungen überwachen Vitalparameter, oder verabreichen Medikamente unter den extremen Bedingungen eines Kernspintomographen und sind weltweit im Einsatz. Entwickelt und produziert wird dabei ausschließlich in Deutschland. Neben der Produktqualität rückt bei MIPM zunehmend auch die Digitalisierung der internen Prozesse in den Fokus.

Der Weg zum passenden Anwendungsfall

Zu Beginn des Projekts mit dem Mittelstand-Digital Zentrum Augsburg gab es noch keine fertige Lösungsvision. Vielmehr durchleuchtete das Unternehmen gemeinsam mit dem KI-Experten Dr. Martin Gottwald und Projektmanagerin Jana Kümmel von fortiss systematisch die bestehenden Abläufe, um konkrete Optimierungspotenziale aufzudecken.

Der Wareneingang erwies sich dabei als idealer Ansatzpunkt. Dort ist eine Begleitdokumentation in Form von Lieferscheinen bei jedem Materialeingang unabdingbar. Die Schwierigkeit im Arbeitsalltag liegt in der Vielfalt, denn jeder Lieferant nutzt ein eigenes Format und das Layout der Papiere variiert stark. Bislang bedeutete dies für das Team einen enormen manuellen Aufwand. Die relevanten Daten aus jedem einzelnen Lieferschein mussten mühsam per Hand ausgelesen, abgetippt und im unternehmensinternen Dokumentenmanagementsystem (DMS) indexiert sowie archiviert werden.
„Das Zentrum hat uns buchstäblich an die Hand genommen und uns dabei geholfen, unser Unternehmen KI-fähig zu machen. Wir wussten anfangs nicht genau, wo die Reise hingeht, aber die gemeinsame Potenzialanalyse war der perfekte Startschuss.“

Jennifer Rosenheimer, Managing Director, MIPM

Automatisierte Dokumentenverarbeitung in der Praxis

Das gemeinsame Ziel war es, die Informationen aus den diversen Lieferscheinen künftig automatisiert auszulesen, dem richtigen Vorgang zuzuordnen und im DMS zu indexieren. Möglich macht dies eine sogenannte OCR-Pipeline.

Anstatt jeden Lieferschein einzeln bearbeiten zu müssen, scannen die Mitarbeitenden im Wareneingang nun alle eingehenden Dokumente gesammelt in einem einzigen Schritt ein. Die eigentliche Fleißarbeit übernimmt das intelligente KI-System im Hintergrund. Es erkennt selbstständig die Dokumentenart, zieht relevante Informationen wie Bestellnummern, Vorgangsnummern oder Lieferanten heraus und legt diese direkt strukturiert im System ab.
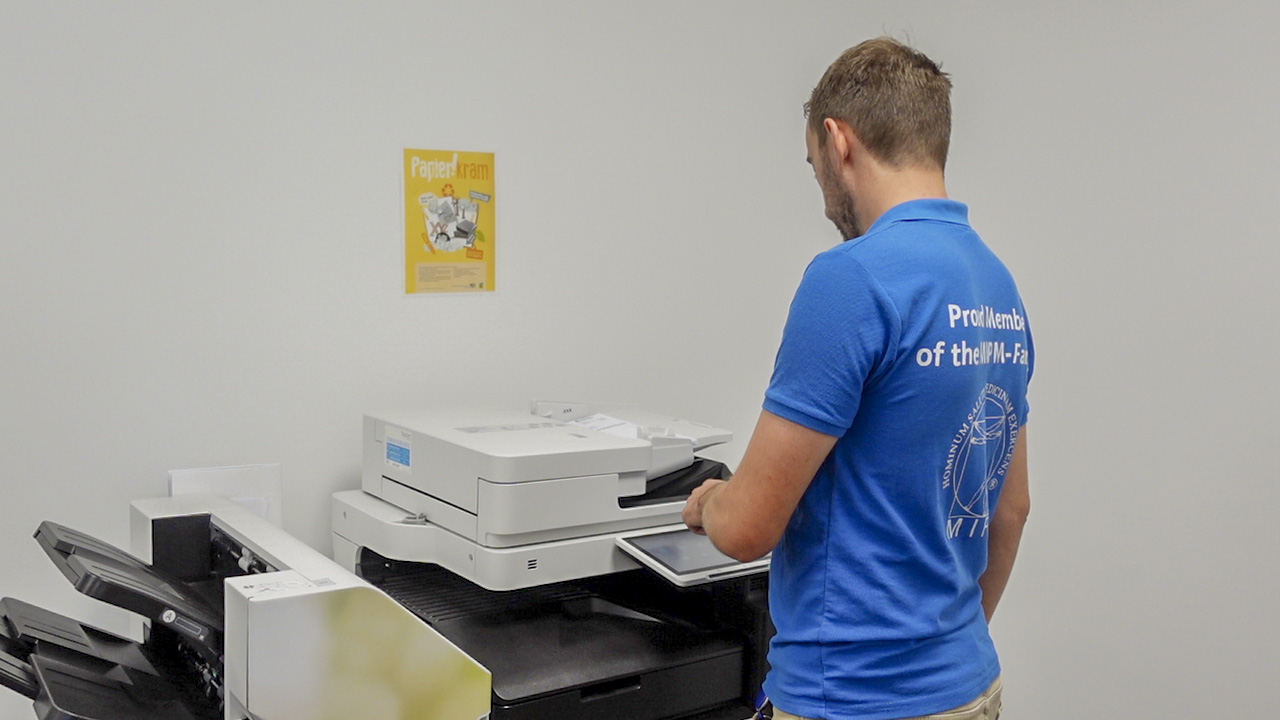
Die OCR-Pipeline

Hinter der Abkürzung OCR (Optical Character Recognition) verbirgt sich die optische Texterkennung. Eine OCR-Pipeline beschreibt einen mehrstufigen, automatisierten Prozess zur Verarbeitung eingescannter Papierdokumente. Im ersten Schritt wandelt die Software das Bild in maschinenlesbaren Text um. In den darauffolgenden KI-gestützten Schritten, beispielsweise mittels Natural Language Processing, analysiert das System den Text. Es erfasst den inhaltlichen Kontext und extrahiert gezielt relevante Datenpunkte wie Datum, Lieferscheinnummer oder Einzelpositionen. Moderne Pipelines bewältigen dabei problemlos Dokumente, die zerknittert sind oder völlig unterschiedliche Layouts aufweisen, und verwandeln so unstrukturierte Bilddaten in verwertbare Informationen.

Nahtloses Andocken an bestehende IT-Systeme

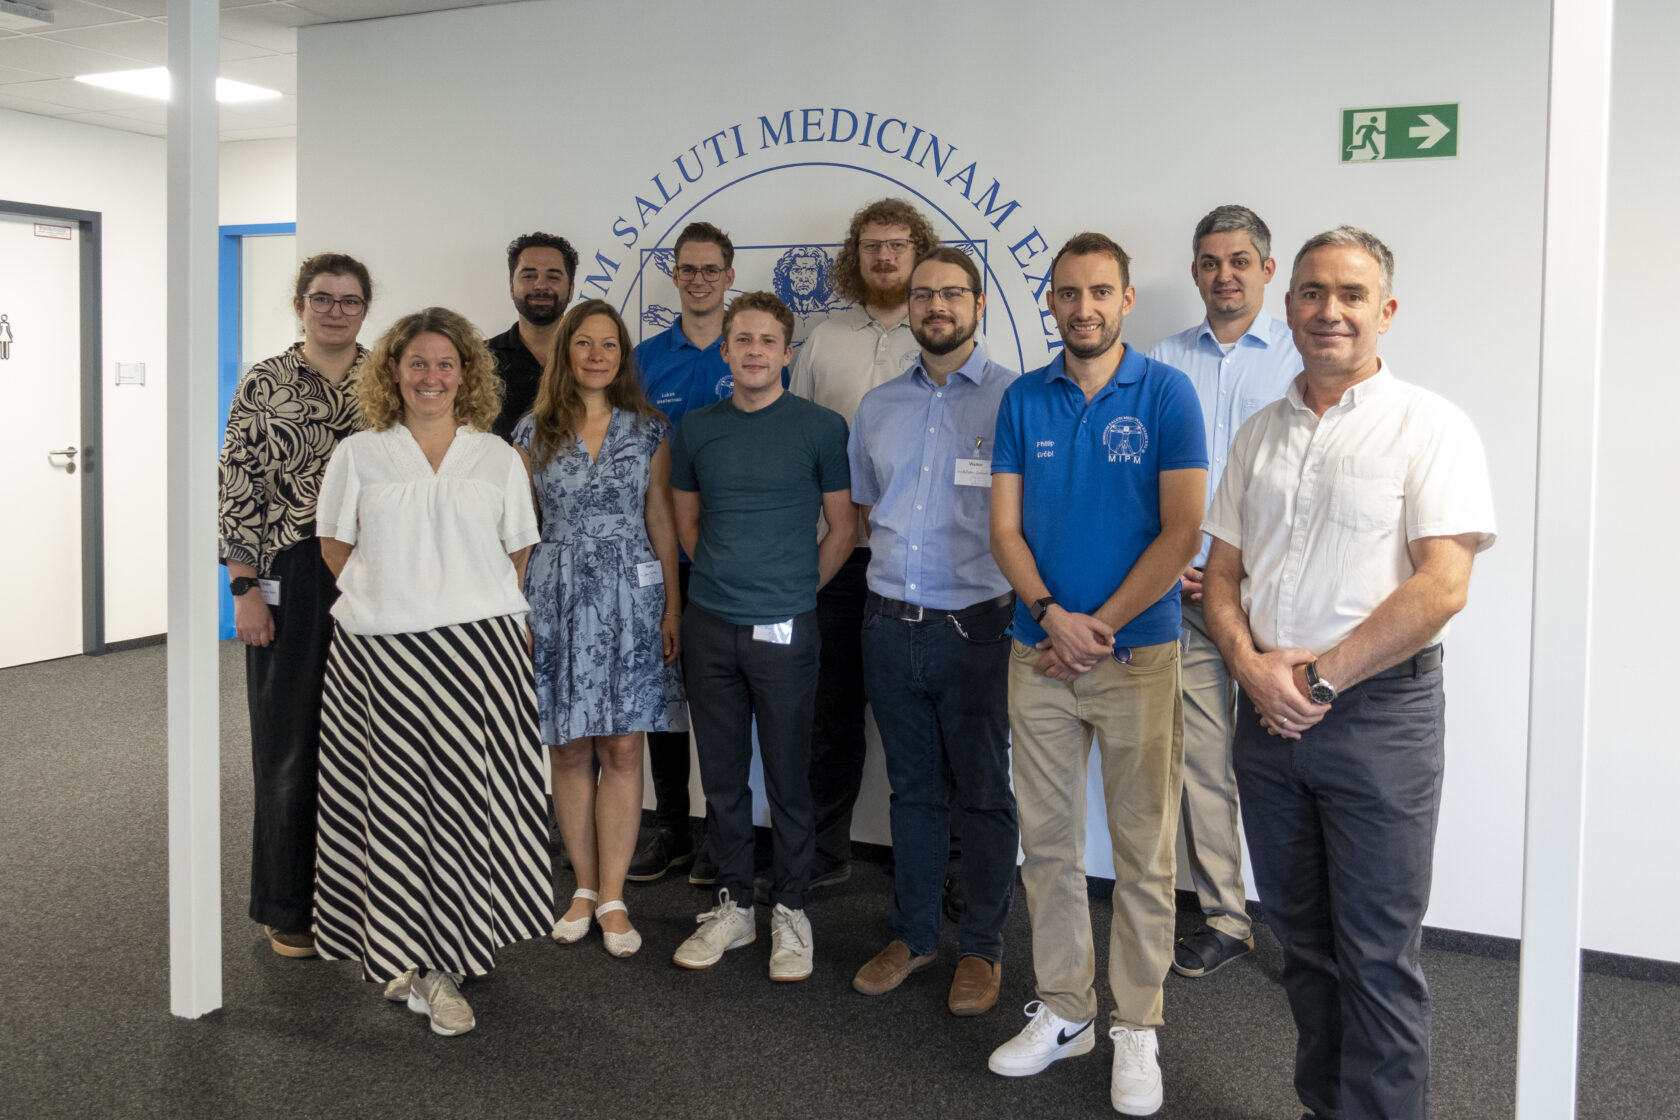
Damit die Lösung im operativen Alltag reibungslos funktioniert, stand nach der Entwicklung des Ansatzes die technische Integration im Fokus. Das Projektteam, auf Seiten von MIPM von Phillip Gröbl begleitet, legte großen Wert darauf, dass das KI-System direkt an die bestehenden Prozesse und das Dokumentenmanagementsystem andockt. Es sollte keine isolierte Insellösung entstehen. Vielmehr fungiert die KI nun als unsichtbarer, aber effizienter Helfer im Hintergrund.

„Das Projekt bei MIPM ist ein hervorragendes Beispiel dafür, dass es absolut möglich ist, Künstliche Intelligenz im eigenen mittelständischen Unternehmen zu implementieren und an bestehende Systeme anzudocken – selbst wenn man in diesem Bereich noch nicht so erfahren ist. Man sollte einfach mutig loslegen. Bei Bedarf kann man sich jederzeit an das Mittelstand-Digital Zentrum wenden, um Unterstützung zu bekommen.“

Jana Kümmel, Projektmanagerin im Mittelstand-Digital Zentrum Augsburg

Zeitersparnis und voller Fokus auf die Kernkompetenzen

Der Mehrwert für das Medizintechnikunternehmen zeigt sich deutlich im Arbeitsalltag. Durch den Wegfall der manuellen Indexierung und Archivierung reduziert sich die Arbeitsbelastung im Wareneingang enorm. Die Mitarbeitenden gewinnen wertvolle Zeit zurück. Statt repetitiver Dateneingabe bleibt wieder mehr Raum für das Wesentliche, nämlich die Konzentration auf die eigenen Kernkompetenzen und die Sicherstellung der Produktqualität.

Das Projekt macht deutlich, wie der Weg vom Papier zum intelligenten Datenstrom gelingen kann und ist ein gelungenes Beispiel für den praxisnahen KI-Einsatz im bayerischen Mittelstand.
Video zum Projekt
Eine schnelle und fundierte Preisermittlung für individuell gefertigte Produkte kann eine große Herausforderung sein. Genau damit beschäftigt sich ein Hersteller für Kennzeichnungslösungen tagtäglich und hat sich daher an das Mittelstand-Digital Zentrum Augsburg gewendet, um zu untersuchen, wie Maschinelles Lernen diesen Prozess unterstützen kann.

Individuelle Produkte statt Standardware

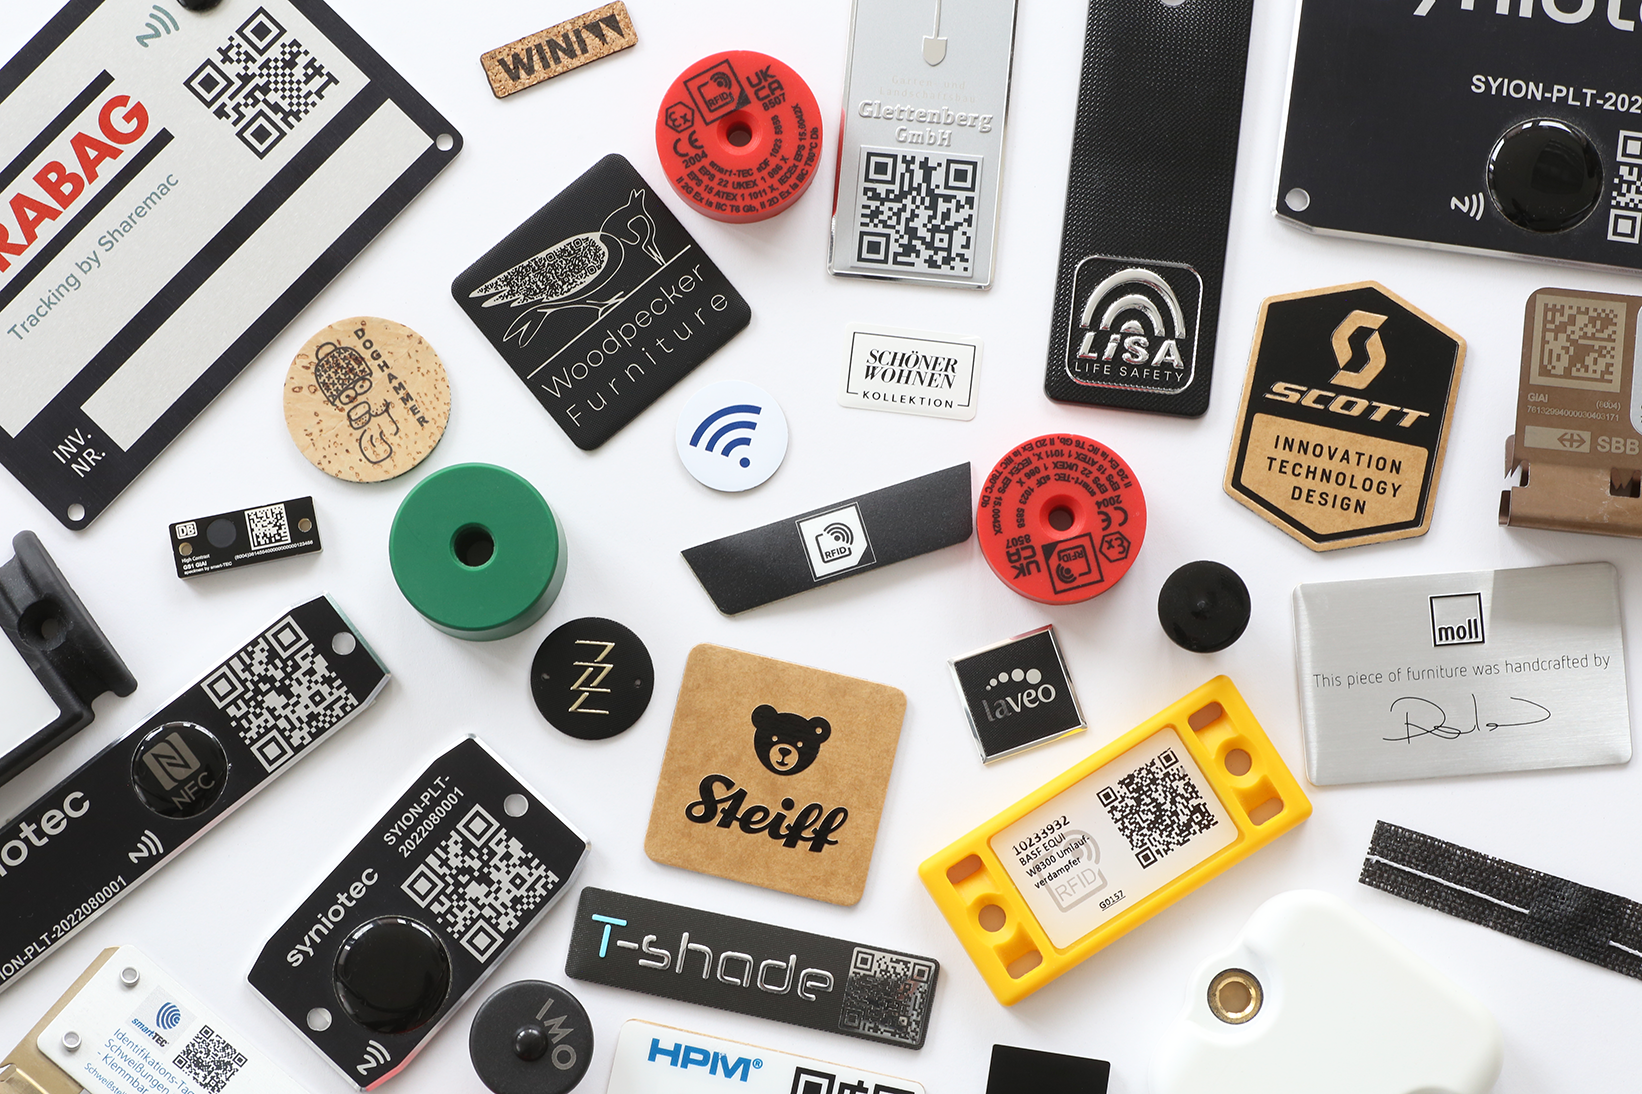
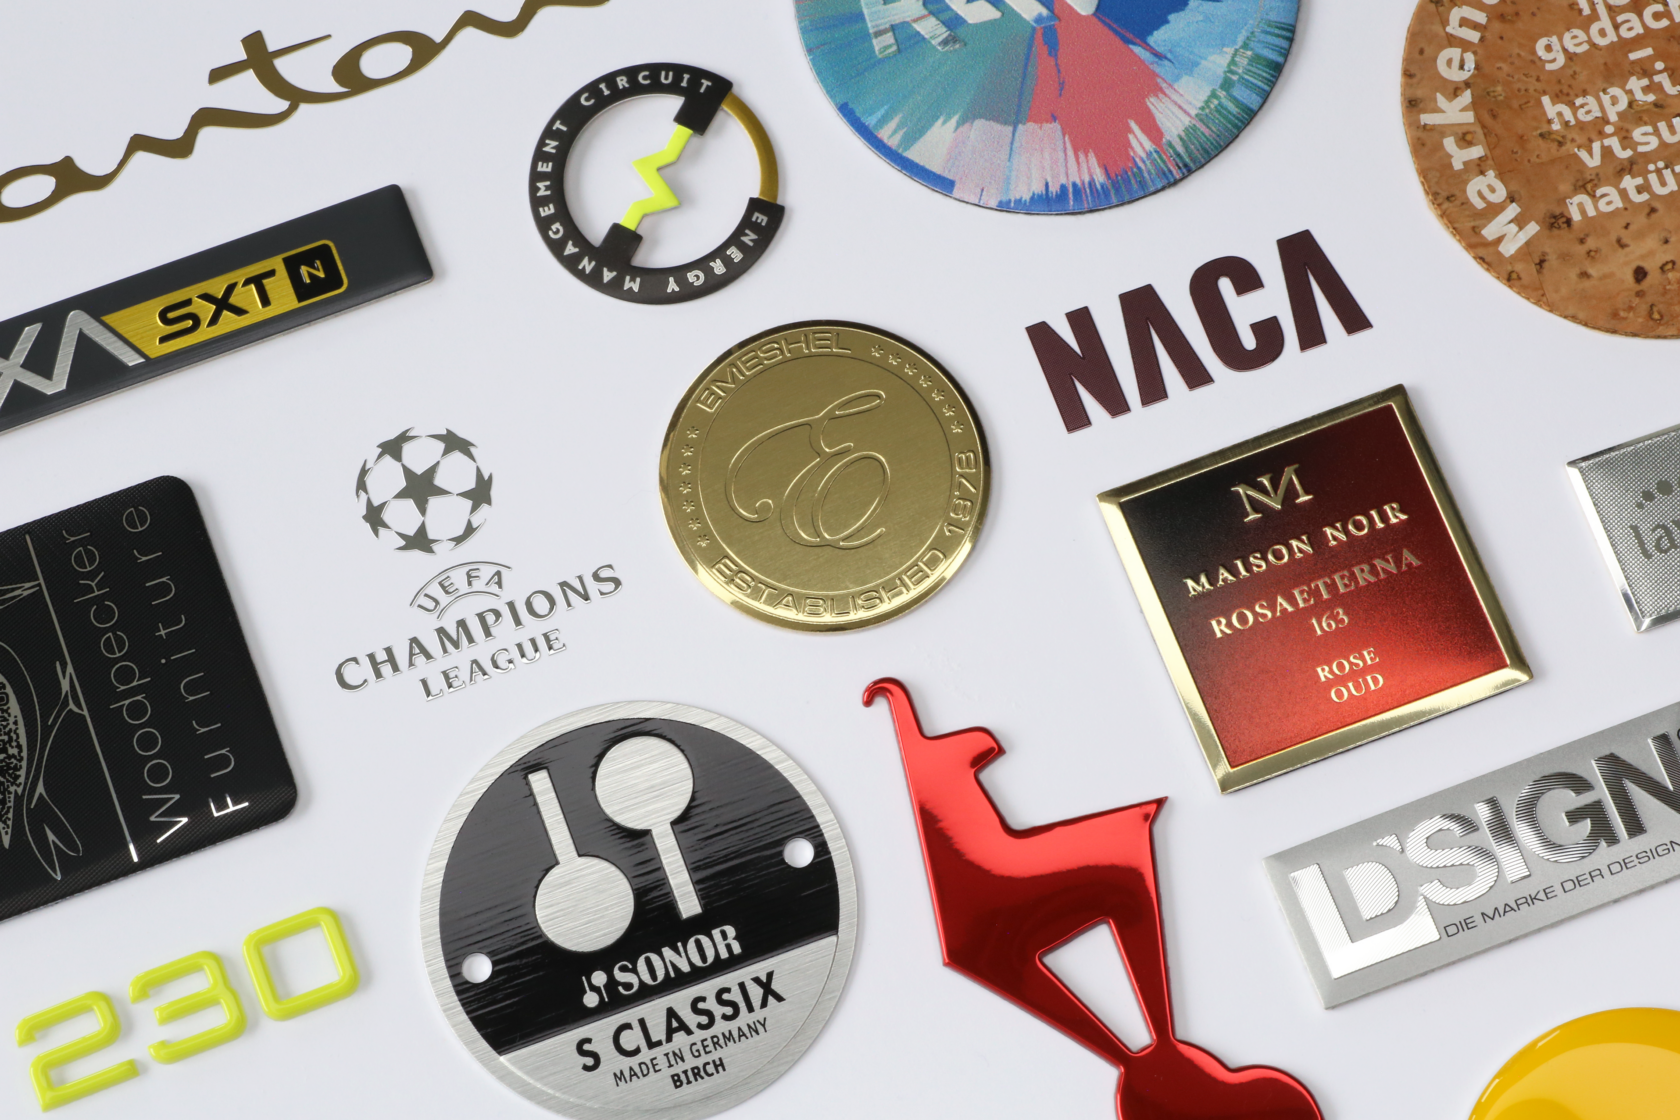
Wie hoch sollte ein Angebotspreis sein, wenn nahezu jedes Produkt maßgeschneidert gefertigt wird? Eine entscheidende Frage für die RATHGEBER GmbH & Co. KG aus Oberhaching. Das familiengeführte Unternehmen entwickelt und produziert mit rund 340 Mitarbeitenden individuelle Kennzeichnungs- und Identifikationslösungen für Firmen unterschiedlicher Branchen. Dazu gehören unter anderem Etiketten, Schilder, Schriftzüge, Embleme und weitere Produktkennzeichnungen, die beispielsweise auf Maschinen, Anlagen oder Produkten zu finden sind. Viele Lösungen werden kundenspezifisch konzipiert und in kleinen Stückzahlen gefertigt.

Diese hohe Individualisierung zählt zu den Stärken des Unternehmens, aber die Vielfalt bringt auch Herausforderungen mit sich. Da sich die Anforderungen von Auftrag zu Auftrag unterscheiden, ist die Preisermittlung häufig komplex. Faktoren wie Stückzahlen, Materialien, Druckverfahren, Farben oder Veredelungen beeinflussen die Kalkulation und müssen berücksichtigt werden. Bis ein Angebot erstellt werden kann, vergeht häufig wertvolle Zeit. In einem wettbewerbsintensiven Umfeld kann die Geschwindigkeit der Angebotserstellung jedoch ein wichtiger Faktor sein.

Historische Daten als Grundlage für Maschinelles Lernen

Geschäftsführer Andreas Schrägle hat gemeinsam mit IT-Leiter Alexander Thoma nach Unterstützungsmöglichkeiten gesucht, um hier Maschinelles Lernen (ML) in den Prozess zu integrieren. So kam es zum KI-Anwendungsprojekt mit dem Mittelstand-Digital Zentrum Augsburg. Das Ziel bestand darin, gemeinsam mit dem Zentrumsexperten Dr. Martin Gottwald von fortiss eine Lösung zu entwickeln, die für neue Produktanfragen automatisiert eine erste Preisschätzung liefern kann.

Bereits vor dem Projekt wurde bei Rathgeber ein selbst entwickeltes Werkzeug zur Preisbestimmung eingesetzt. Damit können verschiedene Einflussgrößen miteinbezogen werden, sodass hilfreiche Anhaltspunkte vorhanden waren. Die zentrale Frage lautete demnach: Lässt sich das über Jahrzehnte aufgebaute Erfahrungswissen mithilfe von Maschinellem Lernen aus historischen Daten ableiten und für neue Anfragen nutzbar machen?

Für die Entwicklung stand eine umfangreiche Datengrundlage aus den Jahren 2021 bis 2025 zur Verfügung unter anderem mit Informationen zu Artikeln, Stückzahlen und Rohstoffpreisen. Auf dieser Basis wurde zunächst eine ML-Pipeline aufgebaut. Schnell hat sich gezeigt, dass ein großer Teil der Projektarbeit nicht in der eigentlichen Modellentwicklung, sondern in der Aufbereitung der Daten liegt: Fehlerhafte Einträge wurden korrigiert, Ausreißer identifiziert und verschiedene Datenquellen zusammengeführt. So waren mehrere Iterationsschleifen notwendig, um die Daten schrittweise in eine Form zu bringen, die für zuverlässige Prognosen genutzt werden konnte.

Maschinelles Lernen

Maschinelles Lernen (engl. Machine Learning) bezeichnet diejenigen Verfahren der Künstlichen Intelligenz, die aus historischen Daten lernen. Anstatt feste Regeln zu programmieren, erkennt das System selbstständig Muster und Zusammenhänge. Auf dieser Grundlage können anschließend Vorhersagen für neue Fälle getroffen werden – beispielsweise für Preise, Produktionszeiten oder Nachfrageentwicklungen.

Welche Modelle eignen sich für Preisprognosen?

Im nächsten Schritt wurden verschiedene Modellansätze untersucht. Der Fokus lag auf neuronalen Netzen sowie sogenannten Random-Forest-Modellen. Neuronale Netze sind in der Lage, komplexe Zusammenhänge in großen Datenmengen zu erkennen. Allerdings ist oft schwer nachvollziehbar, wie eine konkrete Vorhersage zustande kommt. Deshalb werden sie auch als „Black-Box“ bezeichnet.

Random-Forests basieren dagegen auf einer Vielzahl von Entscheidungsbäumen, die gemeinsam eine Prognose erzeugen. Sie gelten als robust und eignen sich besonders für Anwendungsfälle mit vielen unterschiedlichen Einflussgrößen.

Für beide Modellarten wurden mithilfe automatisierter Trainingsläufe unterschiedliche Varianten und Parametereinstellungen getestet und miteinander verglichen. Ziel war es, eine Lösung zu finden, die belastbare Ergebnisse liefert und gleichzeitig mit vertretbarem Rechenaufwand betrieben werden kann. Für diesen Anwendungsfall erwies sich ein Random-Forest als am besten geeignet.

Random Forest

Ein Random-Forest ist ein Verfahren des Maschinellen Lernens, das aus vielen einzelnen Entscheidungsbäumen besteht. Jeder Baum erstellt eine eigene Schätzung auf Basis der vorliegenden Informationen. Aus den Ergebnissen aller Bäume wird anschließend eine gemeinsame Prognose berechnet. Dadurch lassen sich auch komplexe Zusammenhänge zuverlässig modellieren.

Vom ML-Prototyp zum nutzbaren Werkzeug

Die entwickelte ML-Lösung wurde anschließend in einen vollwertigen Software-Prototyp verpackt, welcher per Schnittstelle durch andere Programme aufgerufen werden kann. Dadurch konnte gezeigt werden, wie sich die lernende Komponente in einen späteren Arbeitsablauf integrieren lässt. Neue Produktanfragen können künftig automatisiert analysiert und mit historischen Daten verglichen werden, um schnell eine erste Preisindikation zu erzeugen.

Die Lösung befindet sich derzeit noch in der Weiterentwicklung. Ein wichtiger nächster Schritt wird darin bestehen, die Anwendung vollständig an die vorhandenen Unternehmenssysteme anzubinden und in den operativen Wertschöpfungsprozess zu implementieren.

Für Rathgeber steht dabei nicht nur die schnellere Angebotserstellung im Vordergrund. Ebenso wichtig ist der Aufbau von Wissen und Erfahrung im Umgang mit KI-Technologien. Die im Projekt gewonnenen Erkenntnisse schaffen für das mittelständische Unternehmen eine Grundlage, um ähnliche Ansätze künftig auch auf weitere Fragestellungen und Bereiche zu übertragen.

Video zum Projekt

In diesem Webinar im Rahmen des Förderprojekts edih dina erfahren Sie, wie Energiemonitoringsysteme zur systematischen Erfassung, Überwachung und Analyse von Energieverbräuchen aufgebaut werden können. Ein Experte des Fraunhofer IGCV zeigt anhand eines Praxisbeispiels aus dem Institut ein mögliches Vorgehen auf.

Transparenz über den Energieeinsatz ist die Grundlage, um unnötige Verbräuche sichtbar zu machen und Einsparpotenziale wirksam auszuschöpfen. Besonders kleine und mittlere Unternehmen profitieren von einer belastbaren, auf ihre Anforderungen abgestimmten Datengrundlage: Sie senkt Kosten, reduziert Umweltwirkungen und kann die eigene Wettbewerbsposition stärken. Gleichzeitig bilden Energiedaten die Basis für digitale Anwendungen und KI-gestützte Analysen.

Weitere Infos zum Projekt finden Sie hier: https://www.edih-dibi.de/

Melden Sie sich hier kostenfrei an

Das könnte Sie auch interessieren

Mehr erfahren
PraxisbeispieleProjekte
Mit ML schneller zum Angebot – Preisprognose für Kennzeichnungslösungen

Eine schnelle und fundierte Preisermittlung für individuell gefertigte Produkte kann eine große ...

Mehr erfahren

Mehr erfahren
PraxisbeispieleProjekte
KI-gestütztes Wissensmanagement beim Sondermaschinenbauer

Jeden Tag entstehen in Unternehmen wertvolle Informationen – sei es bei Serviceeinsätzen, ...

Mehr erfahren

Mehr erfahren
Information
Digitaler Produktpass – wie KMU profitieren können

Der Digitale Produktpass (DPP) soll umfassende Informationen über Produkte während ihres gesamten Lebenszyklus ...

Mehr erfahren

Mehr erfahren
PotenzialanalysenPraxisbeispieleProjekte
In einer analogen Druckbranche zum digitalen Geschäftsmodell

Die Mertinger SIGEL GmbH mit ca. 210 Mitarbeitenden aus der Druckbranche bietet eine breite Produktpalette, darunter ...

Mehr erfahren

Mehr erfahren
PotenzialanalysenPraxisbeispiele
Interview über Digitalisierung im Kleinstunternehmen – Offenheit und Neugier machen es möglich

Eine Dreherei mit fünf Mitarbeitenden hat ihren Produktionsprozess nahezu vollständig digitalisiert, aber ...

Mehr erfahren

Mehr erfahren
PotenzialanalysenPraxisbeispiele
Energiemanagement bei großer Anlagenvielfalt im Prototypenbau

Die ModellTechnik Rapid Prototyping GmbH mit ca. 190 Mitarbeitenden in Thüringen fertigt Prototypen für ...

Mehr erfahren

Mehr erfahren
Information
Maschinelles Lernen in der Produktionsplanung

Die Produktionsplanung und -steuerung (PPS) hat das Ziel für eine hohe Auslastung und geringe Bestände zu sorgen, ...

Mehr erfahren

Mehr erfahren
Information
Bedeutung des Datenbestands für erfolgreiche KI-Projekte in KMU

Sie möchten in Ihrem Unternehmen KI-Methoden einsetzen? Dann sollten Sie zuerst Ihren Datenbestand in den Blick ...

Mehr erfahren

Mehr erfahren
Lab TourVeranstaltung
Automatisierung bei der Lab-Tour am TZ PULS

Unter dem Themenschwerpunkt „Intralogistik der Zukunft – Lösungsansätze für den Fachkräftemangel“ fand am 12. ...

Mehr erfahren

Mehr erfahren
PraxisbeispieleProjekte
KI‑basierte Lieferscheinverarbeitung beim Medizingerätehersteller

Täglich treffen im Wareneingang unterschiedliche Lieferungen ein und jede bringt ihre eigenen ...

Mehr erfahren

Mehr erfahren
Information
Wenn Roboter sehen lernen – Bilderkennung und Sensorik in der autonomen Intralogistik

Autonome Stapler, mobile Roboter und erste humanoide Systeme übernehmen im Lager zunehmend ...

Mehr erfahren

Autonome Stapler, mobile Roboter und erste humanoide Systeme übernehmen im Lager zunehmend Aufgaben, die bisher Menschen vorbehalten waren. Voraussetzung dafür ist, dass sie ihre Umgebung zuverlässig erfassen und interpretieren können. Doch wie funktioniert maschinelles Sehen, welche Möglichkeiten eröffnet KI und wo liegen die Grenzen im industriellen Einsatz?

Umgebungswahrnehmung für Roboter

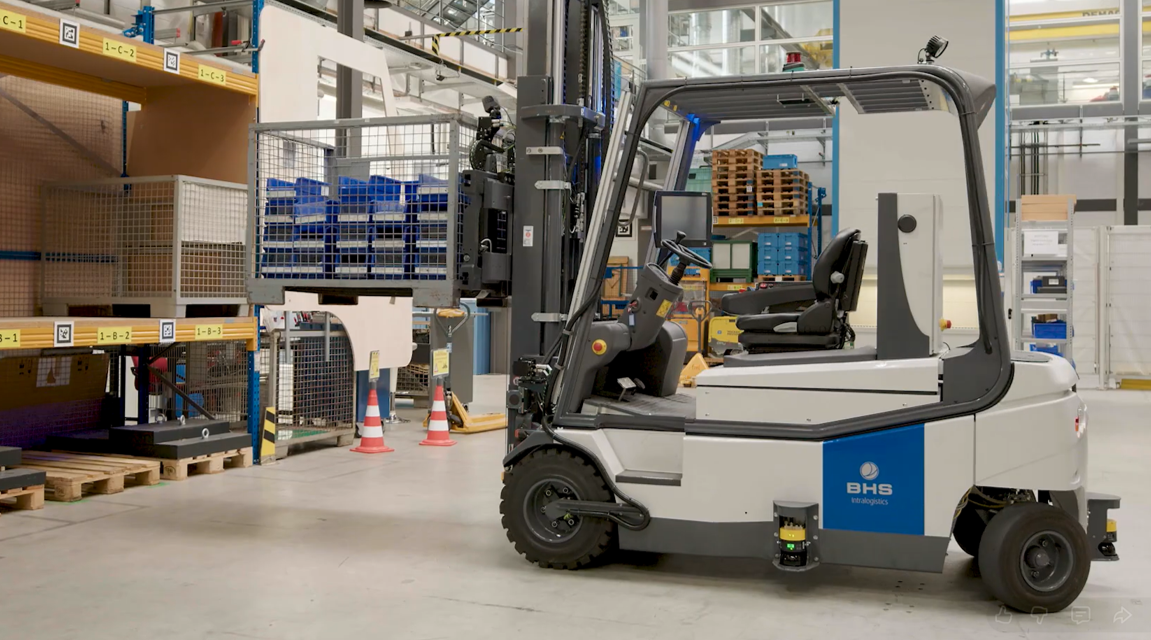
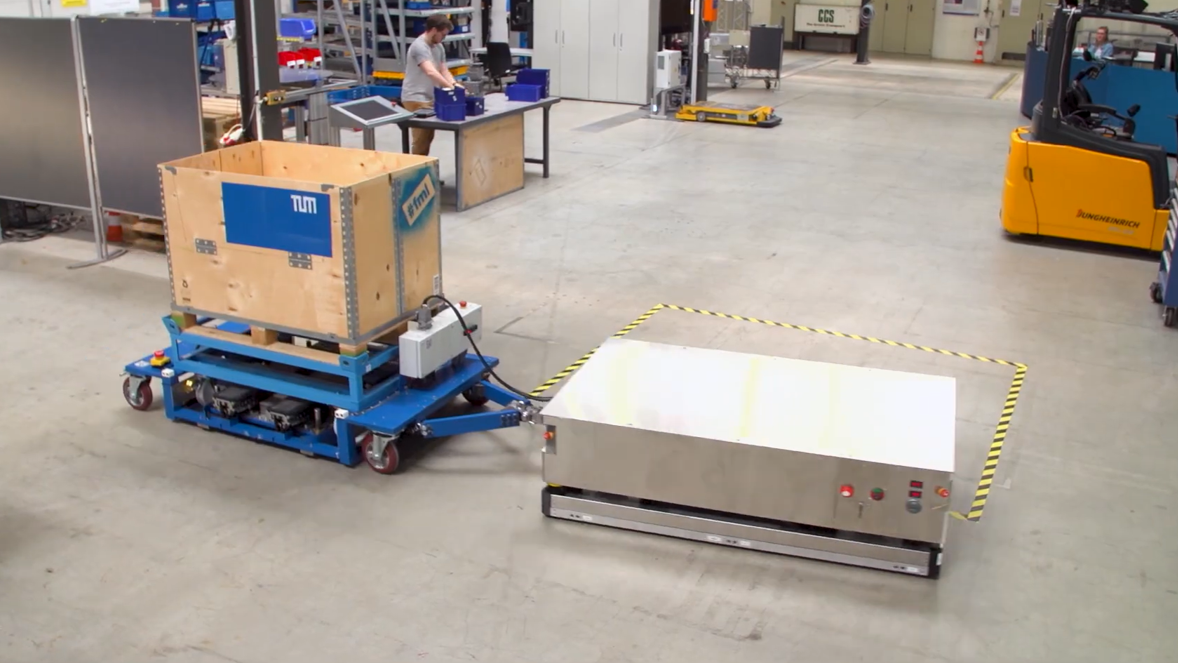
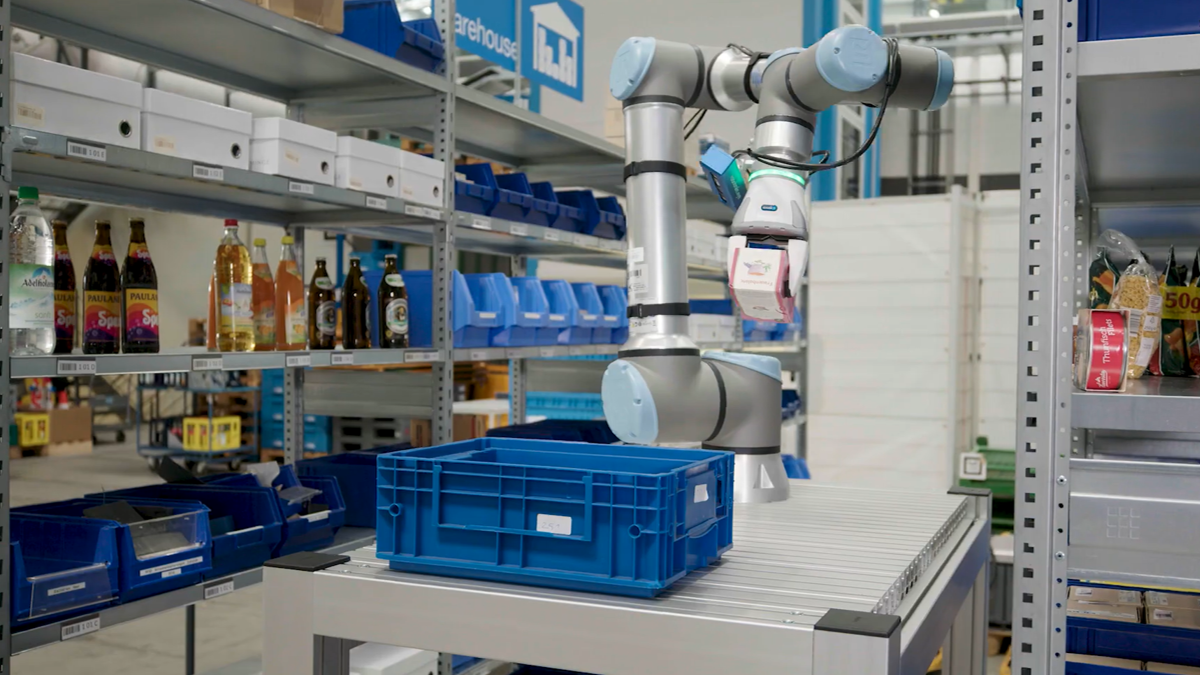
In der Intralogistik arbeiten autonome Gabelstapler, fahrerlose Transportfahrzeuge, mobile Roboter und kollaborierende Roboter zunehmend im selben Raum wie Menschen. Damit sie sich in einer solchen Umgebung sicher und zuverlässig bewegen, müssen sie mehrere grundlegende Aufgaben gleichzeitig beherrschen. Ein Fahrzeug navigiert durch Gänge und Hallenbereiche und bestimmt dabei fortlaufend die eigene Position. Es erkennt Ladungsträger, Regale und Hindernisse und unterscheidet sie von Personen, die sich im Fahrweg aufhalten. Am Ziel kommt es schließlich darauf an, Lasten millimetergenau aufzunehmen und abzusetzen. Grundlage für all diese Fähigkeiten ist eine Sensorik, die die Umgebung ohne Unterbrechung erfasst und dem System ein aktuelles Bild der Situation liefert.

Klassische Bildverarbeitung

Klassische Bildverarbeitung kombiniert Kamera, Beleuchtung und Optik mit einer regelbasierten Auswertung. Das System extrahiert definierte Bildmerkmale und leitet daraus Entscheidungen ab. Ein Beispiel ist die Kantenerkennung nach Canny, die Konturen anhand von Helligkeitsübergängen identifiziert. Der Ansatz ist besonders geeignet, wenn Objekte unter kontrollierten Bedingungen erscheinen. Im Lager erschweren wechselnde Lichtverhältnisse, Verdeckungen und variierende Objektpositionen eine zuverlässige Erkennung. Je weniger sich eine Aufgabe durch feste Regeln beschreiben lässt, desto interessanter werden lernende Verfahren.

KI-basiertes Erkennen

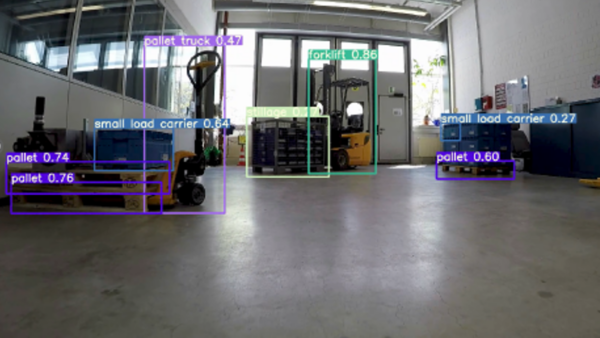
KI-basierte Bilderkennung verfolgt einen grundlegend anderen Ansatz als die klassische Bildverarbeitung. Anstatt Merkmale und Entscheidungsregeln von Hand festzulegen, lernt ein neuronales Netz selbstständig, welche Bildeigenschaften für die Erkennung eines Objekts relevant sind. Den Ausgangspunkt bildet ein Datensatz aus Bildern, in denen die gesuchten Objekte markiert und mit einer Bezeichnung versehen sind. Dieser Schritt wird als Annotation bezeichnet und bestimmt maßgeblich die spätere Erkennungsqualität. Mit den annotierten Bildern wird anschließend ein Modell trainiert, etwa aus der verbreiteten YOLO-Familie (YOLO: You Only Look Once). Das Modell passt dabei seine internen Parameter schrittweise so an, dass es die markierten Objekte immer zuverlässiger findet. Nach Abschluss des Trainings läuft es direkt auf der Recheneinheit des Fahrzeugs. Dort erkennt es Paletten, Behälter oder andere Stapler in Echtzeit, auch bei wechselnder Beleuchtung und unterschiedlichen Perspektiven, und liefert die Information unmittelbar an die Fahrzeugsteuerung.

Multimodale Wahrnehmung

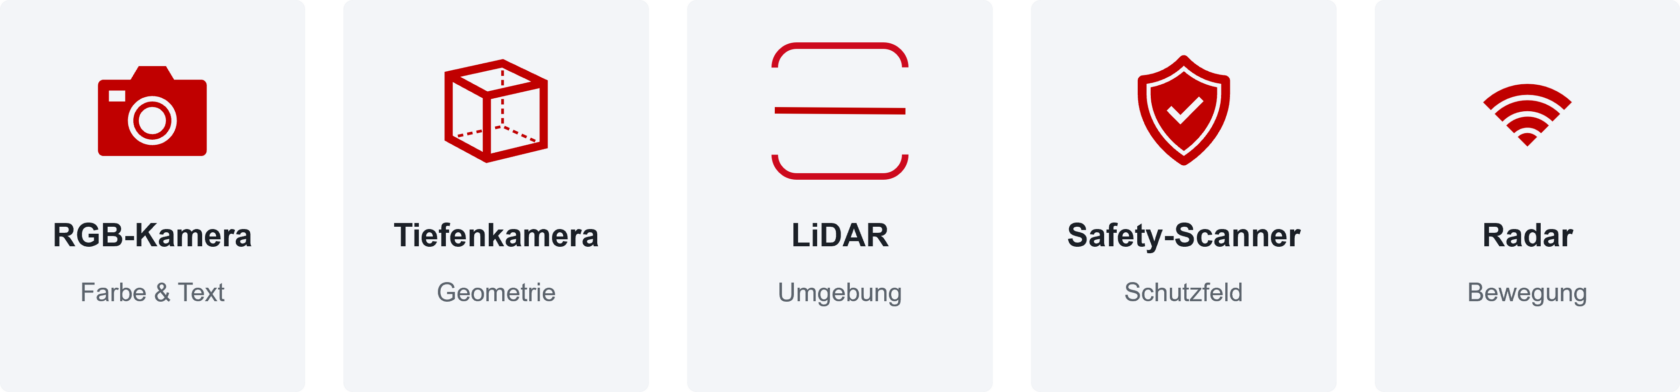
Für die Umgebungswahrnehmung existieren eine Vielzahl von Sensortypen, wobei jeder einen anderen Ausschnitt der Wirklichkeit wahrnimmt.

Sensoren liefern unterschiedliche Datenpunkte und haben verschiedene Einsatzszenarien

Die RGB-Kamera liefert Farbinformationen und macht Beschriftungen, Etiketten oder Barcodes lesbar. Eine Tiefenkamera ergänzt das Bild um räumliche Information und erlaubt es, die Geometrie von Objekten zu bestimmen. LiDAR (Light Detection and Ranging) tastet die Umgebung mit Laserstrahlen ab und erzeugt ein dreidimensionales Abbild der Umgebung, das vor allem für Navigation und Lokalisierung genutzt wird. Der Safety-Scanner überwacht ein definiertes Schutzfeld um das Fahrzeug und löst bei einem Eingriff eine sicherheitsgerichtete Reaktion aus. Radar wiederum erkennt Bewegungen auch unter Bedingungen, in denen optische Sensoren an ihre Grenzen stoßen, etwa bei Staub oder schlechter Sicht. Keiner dieser Sensoren deckt allein alle Anforderungen ab. Erst die Kombination mehrerer Sensoren gleicht die Schwächen der einzelnen Systeme aus und ermöglicht eine robuste Wahrnehmung.

Welche Kombination sinnvoll ist, ergibt sich aus dem jeweiligen Prozess. In der Pickrobotik ermöglicht das Zusammenspiel von RGB- und Tiefendaten, Objekte zu erkennen und ihre Lage so genau zu bestimmen, dass ein Greifer sie sicher aufnehmen kann. Mobile Roboter verbinden LiDAR und Kamera, um Hindernisse zuverlässig zu erkennen und ihren Weg durch die Halle eigenständig zu planen. Bei humanoiden und kollaborierenden Robotern tritt zusätzlich die Verarbeitung von Sprache hinzu. Modelle, die Bild und Text gemeinsam verarbeiten, erlauben es diesen Systemen, Anweisungen von Menschen zu verstehen, Situationen im Zusammenhang zu interpretieren und so enger mit Beschäftigten zusammenzuarbeiten.

Bild und Sprache für flexible Objekterkennung

Ein klassisches KI-Modell zur Objekterkennung kann nur die Klassen erkennen, auf die es zuvor trainiert wurde, beispielsweise Paletten, Kleinladungsträger oder Gitterboxen. Taucht im Prozess ein neues Objekt auf, muss das KI-Modell wieder neu trainiert werden. Zunächst müssen geeignete Bilder gesammelt und manuell annotiert werden, bevor das Netz mit dem erweiterten Datensatz neu trainiert werden kann. Gerade in Lagern mit wechselndem Sortiment und vielfältigen Ladungsträgern wird dieser Kreislauf schnell zum Engpass.

Vision-Language-Modelle verfolgen einen anderen Ansatz. Ein Bild-Encoder zerlegt das Bild in einzelne Bildausschnitte, sogenannte Bild-Tokens, während ein Tokenizer die textuelle Anfrage in Wort-Tokens überführt. Ein Sprachmodell verarbeitet anschließend beide Arten von Tokens gemeinsam und stellt so einen Bezug zwischen Bildinhalt und Sprache her. Dadurch lassen sich Objekte über eine einfache Beschreibung in natürlicher Sprache ansprechen, ohne dass dafür ein eigenes Training erforderlich ist.

Praxisbeispiel – Prompt statt Training

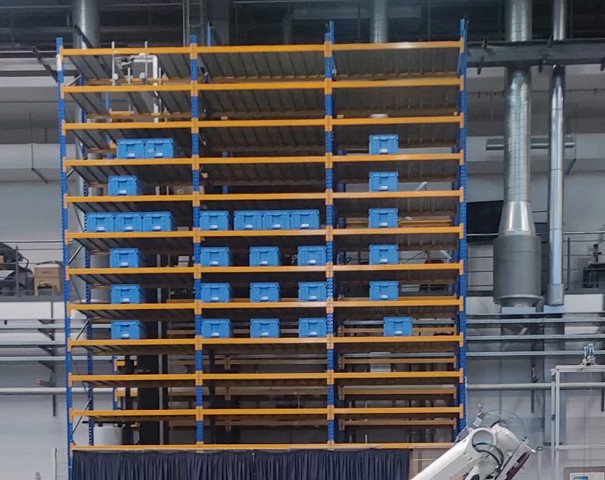
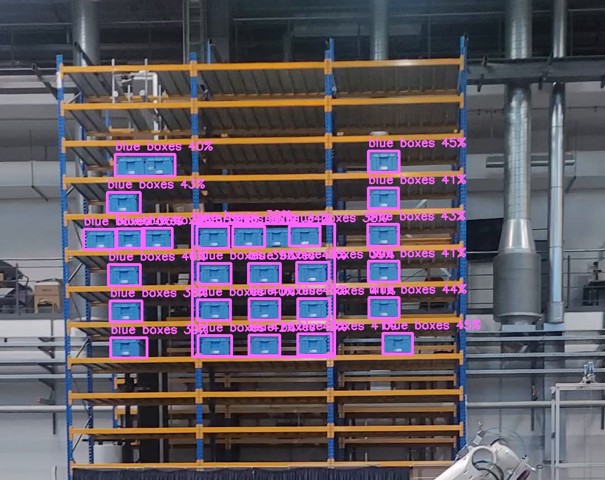
Ausgangslage: In einem Regal sollen Behälter erkannt werden, für die es keinen trainierten Datensatz gibt.

Vorgehen und Ergebnis: Grounding DINO (Vision-Language-Modell) erhält nur den Prompt „blue boxes“ und markiert die blauen Behälter, ganz ohne Annotation und Neutraining.

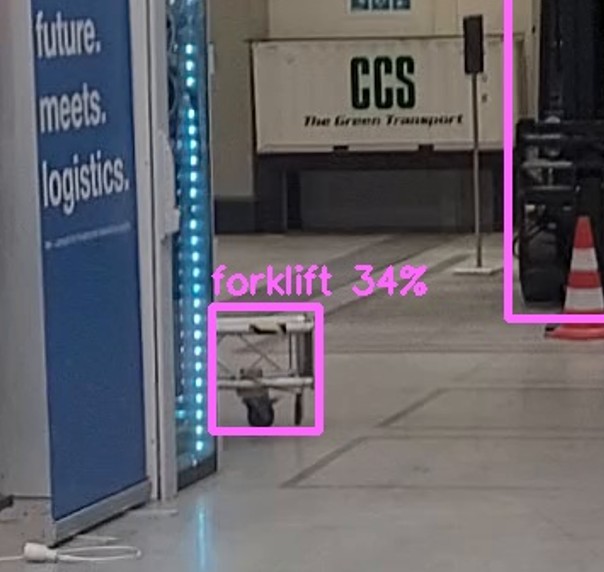
Grenze: Beim Prompt „Forklift“ werden die Stapler gefunden, aber auch ein kleiner Wagen mit 34 % Konfidenz. Schwellwerte und Validierung bleiben nötig.

Physical AI als nächste Entwicklungsstufe

Unter dem Begriff Physical AI (dt. Physische KI) wird die nächste Entwicklungsstufe zusammengefasst, in der KI nicht nur Daten auswertet, sondern in der realen Welt wahrnimmt, entscheidet und handelt. Sehen, Verstehen und Handeln greifen dabei unmittelbar ineinander. Kameras und weitere Sensoren erfassen die Umgebung, ein Modell interpretiert die Szene im Zusammenhang und leitet daraus eine Handlung ab, die der Roboter anschließend ausführt. Der entscheidende Unterschied zu bisherigen Systemen liegt darin, dass Aufgaben nicht mehr im Detail programmiert werden müssen. Eine Anweisung wie „Nimm die unbeschädigte Palette aus Reihe 3 auf.“ verlangt vom System, die richtige Reihe zu finden, mehrere Paletten zu unterscheiden, deren Zustand zu beurteilen und die passende auszuwählen. Solche Anweisungen in natürlicher Sprache werden damit direkt umsetzbar und eröffnen neue Möglichkeiten für flexible Abläufe im Lager.

Fazit – Mehr Autonomie braucht verlässliche Wahrnehmung

Roboter in der Intralogistik lernen zunehmend, Situationen zu bewerten, statt nur vorab festgelegte Regeln abzuarbeiten. Die technische Machbarkeit bedeutet jedoch noch keine industrielle Verlässlichkeit. Wechselndes Licht, Verschmutzung, Verdeckungen und unbekannte Objekte stellen hohe Anforderungen an die Robustheit der Systeme. Ebenso offen ist vielfach die Frage, wie zuverlässig die Aussage eines Modells im Einzelfall ist und wie sich das nachweisen lässt. Nutzbar ist KI-basierte Wahrnehmung heute deshalb vor allem als Assistenzfunktion, die parallel zur bestehenden Sicherheitskette arbeitet. Je selbstständiger Roboter künftig handeln sollen, desto mehr entscheidet ihre Wahrnehmung darüber, welche Aufgaben sie sicher und wirtschaftlich übernehmen können.

Sie nutzen Chatbots in Ihrer täglichen Arbeit noch eher selten oder diese kommen regelmäßig bei Ihnen zum Einsatz, aber Sie sehen Verbesserungspotenzial?

In diesem Webinar lernen Sie, was einen guten Prompt ausmacht, was Sie in Ihrer eigenen Anwendung optimieren können und wie Sie dadurch einen besseren Output generieren.

Zum Verständnis erhalten Sie zunächst eine kurze Einführung in die Funktionsweise von Chatbots sowie eine Anleitung wie Sie gute Prompts bauen. Anhand eines Beispiels wird Ihnen die konkrete Anwendung in der Praxis näher gebracht.

Das Webinar findet in Kooperation mit der IHK für München und Oberbayern im Rahmen der Webinarreihe „Künstliche Intelligenz verstehen und nutzen“ statt.

Zur kostenfreien Anmeldung

Weitere Infos zur Webinarreihe

Das könnte Sie auch interessieren

Mehr erfahren
PraxisbeispieleProjekte
Mit ML schneller zum Angebot – Preisprognose für Kennzeichnungslösungen

Eine schnelle und fundierte Preisermittlung für individuell gefertigte Produkte kann eine große ...

Mehr erfahren

Mehr erfahren
PraxisbeispieleProjekte
KI-gestütztes Wissensmanagement beim Sondermaschinenbauer

Jeden Tag entstehen in Unternehmen wertvolle Informationen – sei es bei Serviceeinsätzen, ...

Mehr erfahren

Mehr erfahren
Information
Digitaler Produktpass – wie KMU profitieren können

Der Digitale Produktpass (DPP) soll umfassende Informationen über Produkte während ihres gesamten Lebenszyklus ...

Mehr erfahren

Mehr erfahren
PotenzialanalysenPraxisbeispieleProjekte
In einer analogen Druckbranche zum digitalen Geschäftsmodell

Die Mertinger SIGEL GmbH mit ca. 210 Mitarbeitenden aus der Druckbranche bietet eine breite Produktpalette, darunter ...

Mehr erfahren

Mehr erfahren
PotenzialanalysenPraxisbeispiele
Interview über Digitalisierung im Kleinstunternehmen – Offenheit und Neugier machen es möglich

Eine Dreherei mit fünf Mitarbeitenden hat ihren Produktionsprozess nahezu vollständig digitalisiert, aber ...

Mehr erfahren

Mehr erfahren
PotenzialanalysenPraxisbeispiele
Energiemanagement bei großer Anlagenvielfalt im Prototypenbau

Die ModellTechnik Rapid Prototyping GmbH mit ca. 190 Mitarbeitenden in Thüringen fertigt Prototypen für ...

Mehr erfahren

Mehr erfahren
Information
Maschinelles Lernen in der Produktionsplanung

Die Produktionsplanung und -steuerung (PPS) hat das Ziel für eine hohe Auslastung und geringe Bestände zu sorgen, ...

Mehr erfahren

Mehr erfahren
Information
Bedeutung des Datenbestands für erfolgreiche KI-Projekte in KMU

Sie möchten in Ihrem Unternehmen KI-Methoden einsetzen? Dann sollten Sie zuerst Ihren Datenbestand in den Blick ...

Mehr erfahren

Mehr erfahren
Lab TourVeranstaltung
Automatisierung bei der Lab-Tour am TZ PULS

Unter dem Themenschwerpunkt „Intralogistik der Zukunft – Lösungsansätze für den Fachkräftemangel“ fand am 12. ...

Mehr erfahren

Mehr erfahren
PraxisbeispieleProjekte
KI‑basierte Lieferscheinverarbeitung beim Medizingerätehersteller

Täglich treffen im Wareneingang unterschiedliche Lieferungen ein und jede bringt ihre eigenen ...

Mehr erfahren

Mehr erfahren
Information
Wenn Roboter sehen lernen – Bilderkennung und Sensorik in der autonomen Intralogistik

Autonome Stapler, mobile Roboter und erste humanoide Systeme übernehmen im Lager zunehmend ...

Mehr erfahren

Dieses Webinar bietet einen kompakten Überblick zum Thema elektronische Rechnung (E-Rechnung).

Es wird erläutert, was dahintersteckt, welche gesetzlichen Vorgaben gelten und welche aktuellen Entwicklungen für Unternehmen relevant sind. Zudem erfolgt eine Übersicht über die verschiedenen Lösungsarten am Markt sowie zentrale Auswahlkriterien für das eigene Unternehmen. Darüber hinaus wird aufgezeigt, wie strukturierte Rechnungsdaten Abläufe vereinfachen, Fehler reduzieren und Zeit sparen können. Abschließend wird dargestellt, wie Künstliche Intelligenz im Umfeld der E-Rechnung unterstützen und zusätzliche Effizienzpotenziale erschließen kann.​​​

Die Veranstaltung findet in Kooperation mit dem Mittelstand-Digital Zentrum Saarbrücken im Rahmen der Themenreihe „KI anwenden“ statt.

Zur kostenfreien Anmeldung

Das könnte Sie auch interessieren

Mehr erfahren
PraxisbeispieleProjekte
Mit ML schneller zum Angebot – Preisprognose für Kennzeichnungslösungen

Eine schnelle und fundierte Preisermittlung für individuell gefertigte Produkte kann eine große ...

Mehr erfahren

Mehr erfahren
PraxisbeispieleProjekte
KI-gestütztes Wissensmanagement beim Sondermaschinenbauer

Jeden Tag entstehen in Unternehmen wertvolle Informationen – sei es bei Serviceeinsätzen, ...

Mehr erfahren

Mehr erfahren
Information
Digitaler Produktpass – wie KMU profitieren können

Der Digitale Produktpass (DPP) soll umfassende Informationen über Produkte während ihres gesamten Lebenszyklus ...

Mehr erfahren

Mehr erfahren
PotenzialanalysenPraxisbeispieleProjekte
In einer analogen Druckbranche zum digitalen Geschäftsmodell

Die Mertinger SIGEL GmbH mit ca. 210 Mitarbeitenden aus der Druckbranche bietet eine breite Produktpalette, darunter ...

Mehr erfahren

Mehr erfahren
PotenzialanalysenPraxisbeispiele
Interview über Digitalisierung im Kleinstunternehmen – Offenheit und Neugier machen es möglich

Eine Dreherei mit fünf Mitarbeitenden hat ihren Produktionsprozess nahezu vollständig digitalisiert, aber ...

Mehr erfahren

Mehr erfahren
PotenzialanalysenPraxisbeispiele
Energiemanagement bei großer Anlagenvielfalt im Prototypenbau

Die ModellTechnik Rapid Prototyping GmbH mit ca. 190 Mitarbeitenden in Thüringen fertigt Prototypen für ...

Mehr erfahren

Mehr erfahren
Information
Maschinelles Lernen in der Produktionsplanung

Die Produktionsplanung und -steuerung (PPS) hat das Ziel für eine hohe Auslastung und geringe Bestände zu sorgen, ...

Mehr erfahren

Mehr erfahren
Information
Bedeutung des Datenbestands für erfolgreiche KI-Projekte in KMU

Sie möchten in Ihrem Unternehmen KI-Methoden einsetzen? Dann sollten Sie zuerst Ihren Datenbestand in den Blick ...

Mehr erfahren

Mehr erfahren
Lab TourVeranstaltung
Automatisierung bei der Lab-Tour am TZ PULS

Unter dem Themenschwerpunkt „Intralogistik der Zukunft – Lösungsansätze für den Fachkräftemangel“ fand am 12. ...

Mehr erfahren

Mehr erfahren
PraxisbeispieleProjekte
KI‑basierte Lieferscheinverarbeitung beim Medizingerätehersteller

Täglich treffen im Wareneingang unterschiedliche Lieferungen ein und jede bringt ihre eigenen ...

Mehr erfahren

Mehr erfahren
Information
Wenn Roboter sehen lernen – Bilderkennung und Sensorik in der autonomen Intralogistik

Autonome Stapler, mobile Roboter und erste humanoide Systeme übernehmen im Lager zunehmend ...

Mehr erfahren

Möglichst viele Bestellungen noch am Tag ihres Eingangs liefern und gleichzeitig Lagerflächen effizient nutzen: Für Unternehmen mit tausenden Artikeln ist das ein echter Spagat. Gemeinsam mit dem Mittelstand-Digital Zentrum Augsburg hat ein Hersteller für Optoelektronik untersucht, wie sich Nachfrageentwicklungen, Lieferzeiten und Bestellmengen mithilfe von Datenanalyse und KI besser vorhersagen und bestimmen lassen.

Zentrale Logistik für den europäischen Markt

Die Thorlabs GmbH entwickelt und produziert optische sowie photoakustische Geräte. Zum Sortiment zählen unter anderem Mess- und Laborgeräte sowie weitere Bestandteile für den Laboreinsatz. Die Produktionsstandorte in Europa sind jeweils auf unterschiedliche Komponenten spezialisiert. Rund 90 Prozent der mehr als 25.000 in Deutschland geführten Artikel stammen aus der unternehmenseigenen Produktion.

Im Distributionszentrum in Bergkirchen laufen die Produkte zusammen und werden für Kunden in Europa versendet. Rund 100 Mitarbeitende sorgen dafür, dass die benötigten Produkte zur richtigen Zeit verfügbar sind. Eine wichtige Rolle übernimmt dabei das Logistikteam um Jürgen Kotzer, Director European Logistics, und Mareike May, Logistics Planner. Zu ihren Aufgaben gehören die Bestandsplanung, die Berechnung von Sicherheitsbeständen und die Koordination von Bestellungen über verschiedene Standorte hinweg.

Hohe Lieferfähigkeit trifft auf begrenzte Lagerkapazitäten

Das Unternehmen verfolgt die Vision der Same Day Delivery: Bestellungen sollen noch am Tag ihres Eingangs geliefert werden. Bei zahlreichen Artikeln gelingt dies bereits, setzt jedoch ausreichende Sicherheitsbestände im zentralen Lager voraus. Daraus entsteht ein Zielkonflikt: Hohe Bestände verbessern die Lieferfähigkeit, binden aber Kapital und benötigen Lagerfläche.

Hinzu kommen saisonale Schwankungen beispielsweise wenn Schulen und Hochschulen ins neue Jahr starten und dort die Labore ausgestattet werden. Auch einzelne Projektgeschäfte erschweren die Planung. Bestellt ein Kunde einmalig eine sehr große Menge, kann dies die historischen Nachfragedaten erheblich beeinflussen: Wird eine solche Bestellung wie ein regelmäßig auftretender Bedarf behandelt, führt das möglicherweise zu überhöhten Beständen, aber wird sie hingegen nicht angemessen berücksichtigt, können bei vergleichbaren Bestellungen Artikel im Lager fehlen.

Das Unternehmen war daher auf der Suche nach einem Ansatz, der bestehende Daten besser nutzbar macht und Mitarbeitende bei Bestandsentscheidungen unterstützt.

Ausreißer erkennen und Lieferzeiten realistischer einschätzen

Gemeinsam mit dem Projektteam des Mittelstand-Digital Zentrums Augsburg rund um Dr. Ursula Neumann vom Fraunhofer IIS wurde ein Use Case ausgearbeitet, der für die Bestandsplanung eine belastbarere Datengrundlage schaffen soll. Im Mittelpunkt standen dabei zwei Fragestellungen: Wie lassen sich ungewöhnliche Bestellmengen automatisch erkennen? Und wie können zukünftige Bedarfe und Lieferzeiten zuverlässiger prognostiziert werden? Auf Unternehmensseite begleitete Tilman Voss als ERP-Spezialist das Projekt und verantwortete die Bereitstellung und Auswertung der Daten.

Das Projekt wurde insgesamt in zwei Arbeitspakete gegliedert. Im ersten Arbeitspaket wurden die Aufbereitung der Bestandsdaten, die Erkennung ungewöhnlicher Bestellmengen sowie Prognosen für zukünftige Bedarfe und Lieferzeitabweichungen fokussiert. Zunächst wurden historische Bestell-, Bestands- und Lieferdaten analysiert. Dabei verdeutlichte sich, dass außergewöhnlich große Bestellungen einen erheblichen Einfluss auf die Planung haben können. Daher wurde eine Anomaliedetektion durchgeführt: Mithilfe statistischer Verfahren wurden diese Ausreißer identifiziert und gemeinsam mit dem Unternehmen bewertet. So konnte nachvollziehbar festgelegt werden, welche Werte für zukünftige Analysen berücksichtigt werden sollen.

Anomaliedetektion

Die Anomaliedetektion bezeichnet Verfahren, mit denen ungewöhnliche Werte oder Muster in Daten erkannt werden. In der Bestandsplanung kann sie beispielsweise besonders große Einzelbestellungen identifizieren, die nicht dem üblichen Nachfrageverhalten entsprechen. Dadurch lässt sich vermeiden, dass einmalige Projektgeschäfte reguläre Bedarfsprognosen unverhältnismäßig stark beeinflussen. Für die Erkennung können feste statistische Regeln oder selbstlernende KI-Verfahren eingesetzt werden.

Ein weiterer Schwerpunkt des ersten Arbeitspakets lag auf den Lieferzeiten. Dazu verglich das Projektteam die in den Stammdaten hinterlegten Lieferzeiten mit den tatsächlich eingetretenen Werten. Die Abweichungen wurden nach Merkmalen wie Monaten, Produktgruppen, internen Lieferanten und Versandarten ausgewertet. Auf diese Weise ließ sich herausfinden, unter welchen Bedingungen Lieferungen häufiger verspätet eintreffen.

Darauf aufbauend wurde ein mehrstufiges Prognoseverfahren konzipiert: Zunächst stellt ein Klassifikationsmodell fest, ob eine Bestellung voraussichtlich verspätet eintreffen wird. Ist dies der Fall, prognostiziert ein Regressionsmodell im zweiten Schritt, um wie viele Tage die festgelegte Lieferzeit voraussichtlich überschritten wird. Ein ergänzendes Regelsystem bewertet die Unsicherheit der Prognose und prüft, ob der vorhergesagte Wert aussagekräftig genug ist, um den statischen Vorgabewert zu ersetzen.

Klassifikation und Regression

Klassifikation und Regression sind Verfahren aus dem Maschinellen Lernen. Eine Klassifikation ordnet einen Fall einer bestimmten Kategorie zu. Im Projekt wurde damit vorhergesagt, ob eine Bestellung voraussichtlich pünktlich oder verspätet eintrifft. Eine Regression prognostiziert dagegen einen numerischen Wert, beispielsweise die Anzahl der Tage, um die eine Lieferung vom vorgesehenen Termin abweicht.

Bedarfe mehrere Wochen im Voraus prognostizieren

Neben den Lieferzeiten wurden auch zukünftige Bedarfe betrachtet. Dazu wurden elf verschiedene statistische, maschinelle und KI-basierte Prognosemodelle miteinander verglichen. Ziel war es herauszufinden, welche Methoden sich für verschiedene Nachfrageverläufe am besten eignen.

Dabei zeigte sich, dass Artikel sehr unterschiedliche Nachfrageprofile aufweisen können. Während einige Produkte regelmäßig und gut vorhersehbar nachgefragt werden, treten bei anderen längere Phasen ohne Nachfrage und anschließend starke Ausschläge auf. Entsprechend eignen sich nicht alle Prognoseverfahren gleichermaßen für jeden Artikel. Zusätzlich wurden Zeitreihen analysiert, um saisonale Muster von langfristigen Entwicklungen zu unterscheiden. Dadurch lässt sich beispielsweise feststellen, ob die Nachfrage eines Produkts dauerhaft wächst oder lediglich zu bestimmten Zeitpunkten im Jahr ansteigt.

Auf diesen Ergebnissen aufbauend wurde im zweiten Arbeitspaket untersucht, wie sich KI-basierte Bestellentscheidungen langfristig bewerten und durch mathematische Optimierung weiterentwickeln lassen. Dazu wurden Nachfrageprognosen, Bestandsinformationen und Lieferzeiten in Modellrechnungen zusammengeführt, um auf Basis dieser Informationen bestmögliche Bestellentscheidungen treffen zu können. Die Unsicherheiten in Nachfrage und Lieferzeiten erhöhen hier die Komplexität immens. Ein mathematisches Optimierungsmodell berücksichtigt neben den gesammelten Daten explizit die Unsicherheiten und macht auf deren Grundlage konkrete Bestellvorschläge, die den zentralen Zielkonflikt zwischen Warenverfügbarkeit und Kosten gegeneinander abwägen. Kenngrößen wie das Servicelevel spielen dabei eine essenzielle Rolle. Über einen historischen Zeitraum wurden die KI-basierten Bestellvorschläge simuliert und mit den historischen Bestellungen verglichen. Die Berechnungen zeigten, dass sich bestehende Verfahren zur Bestandsplanung sinnvoll durch Prognosen, eine automatisierte Anomaliedetektion und realistischere Lieferzeitwerte ergänzen lassen. Darüber hinaus können auf Basis dieser Informationen durch ein mathematisches Optimierungsmodell automatisiert konkrete Bestellmengen und -zeitpunkte abgeleitet werden.

Datengrundlage für die Weiterentwicklung der Bestandsplanung

Diese umfangreiche Datengrundlage mit Analysen, Prognosen und Handlungsempfehlungen lässt sich nun für die weitere Optimierung der Bestandsplanung nutzen. Die Ergebnisse helfen dabei, Nachfrageentwicklungen und Lieferzeiten besser einzuschätzen sowie ungewöhnliche Bestellungen frühzeitig zu erkennen.

„Das Projekt war ein voller Erfolg und hat uns wesentliche wichtige Erkenntnisse geliefert: Wir haben gelernt, dass durch den Einsatz unterschiedlicher mathematischer Modelle unsere doch sehr heterogene Produktlandschaft erfolgreich abgebildet werden kann. Dies können wir dann innerhalb eines einheitlichen Prozesses zusammenführen und abbilden und somit deutlich besser planen.“

Tilman Voss, ERP-Spezialist, Thorlabs

Perspektivisch können die entwickelten Ansätze schrittweise in bestehende Prozesse und Systeme (z. B. ERP-System) integriert und die Bestandsplanung dadurch zunehmend automatisiert werden. So konnte im Projekt verdeutlicht werden, dass durch die Kombination aus Datenanalyse, statistischen Verfahren und KI neue Möglichkeiten entstehen, um Lieferfähigkeit und Bestandsmanagement besser miteinander in Einklang zu bringen.

Jeden Tag entstehen in Unternehmen wertvolle Informationen – sei es bei Serviceeinsätzen, Kundenanfragen oder der Inbetriebnahme von Maschinen. Doch häufig sind diese auf verschiedene Systeme verteilt und damit nur schwer auffindbar. Ein Sondermaschinenbauer wollte diese Herausforderung gemeinsam mit dem Mittelstand-Digital Zentrum Augsburg lösen. Herausgekommen ist ein Ansatz, bei dem Künstliche Intelligenz hilft, vorhandenes Unternehmenswissen einfacher zugänglich zu machen.

Wissen über verschiedene Systeme verteilt

Die Dorst Technologies GmbH mit Sitz in Kochel am See produziert Maschinen und Anlagen zur Herstellung und Formgebung von Sintermetallen, Hartmetallen und keramischen Pulvern. Im Unternehmen ist umfangreiches Wissen vorhanden und wird täglich erweitert – durch Servicemeldungen, technische Dokumentationen sowie Erfahrungswerte aus dem Kundenservice.

Diese Informationen sind jedoch über zahlreiche isolierte Systeme und Abteilungen verteilt unter anderem im ERP-System, dem firmeninternen Wiki, E-Mail-Postfächern sowie verschiedenen Dateiablagen und Archivsystemen. Teilweise liegen Informationen mehrfach vor und gleichzeitig sind dazugehörige Dokumente maschinell nicht auslesbar. Zudem ist der manuelle Aufwand der Datenpflege im internen Wiki für die Mitarbeitenden sehr hoch, die Informationen werden nicht immer einheitlich oder vollständig dokumentiert und die Zuständigkeiten sind unklar.

All das erschwert die tägliche Arbeit, denn will ein Servicemitarbeitender beispielsweise herausfinden, ob eine bestimmte Fehlermeldung bereits bekannt ist, müssen zeitaufwändig oft mehrere Systeme durchsucht werden und bei unvollständiger Dokumentation ist wertvolles Erfahrungswissen nur eingeschränkt nutzbar.

Analyse der bestehenden Prozesse

Um das Wissen künftig zu sichern und ein einheitliches Vorgehen zu etablieren, wollte der Sondermaschinenbauer Künstliche Intelligenz nutzen. Herbert Gröbl, Leiter der IT, wurde hier durch das Projektteam des Mittelstand-Digital Zentrums Augsburg rund um Florian Spiegel, Markus Ludsteck und Justine Forest von der Technischen Universität München unterstützt.

„Unsere Erwartungshaltung war, ein Konzept zu bekommen, wie wir mit KI-Unterstützung unsere Daten – die in allen möglichen Plattformen gespeichert sind – wie wir das zusammenführen können und für unsere Mitarbeiterinnen und Mitarbeiter ein System bauen können, das leicht zu bedienen ist und vor allen Dingen das versteckte Wissen in diesen verschiedenen Plattformen tatsächlich hebt.“

Herbert Gröbl, Leiter IT, Dorst Technologies

Zu Beginn des Vorhabens wurden die bestehenden Prozesse durch Interviews mit den Mitarbeitenden aus Service, Technik, Konstruktion und IT untersucht. Der aktuelle Umgang mit Wissen im Unternehmen konnte so analysiert und konkrete Bedarfe für ein zukünftiges Wissensmanagement identifiziert werden.

Die Auswertung hat gezeigt, dass weniger fehlendes Wissen als vielmehr dessen Verfügbarkeit aufgrund der unterschiedlichen Formate und Systeme die zentrale Herausforderung darstellt. Gleichzeitig hat sich das ERP-System als die vollständigste und am konsequentesten gepflegte Wissensquelle des Unternehmens erwiesen. Daher wurde entschieden, dort den Ausgangspunkt für eine zukünftige Lösung zu setzen.

Wissensmanagement

Wissensmanagement fasst alle strategischen und operativen Tätigkeiten sowie Managementaufgaben zusammen, um die strukturierte Erfassung, Speicherung und Bereitstellung von Wissen innerhalb eines Unternehmens zu gewährleisten. Ziel ist es, Erfahrungswerte, Dokumentationen und Fachwissen dauerhaft zugänglich zu machen, damit Informationen nicht nur einzelnen Mitarbeitenden zur Verfügung stehen, sondern im gesamten Unternehmen genutzt werden können.

KI-gestützte Wissenssuche mit Retrieval Augmented Generation

Mit dieser Analyse hat das Projektteam ein Konzept für eine zentrale Wissensplattform entwickelt. Mitarbeitende sollen künftig über eine einheitliche Oberfläche auf relevantes Wissen zugreifen können – unabhängig davon, wo die Informationen ursprünglich gespeichert wurden.

Die Bedienung ist dabei als Chatbot vorgesehen, der sowohl am Arbeitsplatz als auch mobil genutzt werden kann. Meldet beispielsweise eine Maschine einen bestimmten Fehlercode, soll das System automatisch ähnliche Fälle, bereits dokumentierte Lösungswege und relevante Unterlagen anzeigen.

Für die technische Umsetzung wurde Retrieval Augmented Generation als sinnvollste Lösung identifiziert, wobei die KI relevante Unternehmensdaten durchsucht und diese Informationen anschließend für die Antwortgenerierung nutzt. Dabei dient das ERP-System als primäre Quelle, aber auch das Wiki, technische Dokumentationen oder PDF-Dateien können als sekundäre Quellen in die Suche einbezogen werden.

Retrieval Augmented Generation (RAG)

Retrieval Augmented Generation (dt.: Abfrage-erweiterte Generierung) ist eine Hybrid-Architektur, die die sprachliche Kompetenz eines Großen Sprachmodells (Large Language Model, kurz LLM) mit dem fachlichen Tiefenwissen einer externen Datenbank kombiniert. Statt ein KI-Modell aufwendig neu zu trainieren, greift RAG gezielt auf bestehende Dokumente zu, sodass Antworten auf Basis aktueller und unternehmensinterner Informationen generiert werden können.

Zunächst werden relevante Informationen aus unterschiedlichen Systemen aufbereitet und in einer sogenannten Vektordatenbank gespeichert. Im Gegensatz zur rein schlagwortbasierten Suche ermöglicht die Vektorsuche, Informationen anhand ihrer semantischen Ähnlichkeit zu finden. Dadurch können Zusammenhänge zwischen Dokumenten erkannt werden, selbst wenn unterschiedliche Begriffe verwendet werden. Hierfür werden Texte in Vektoren (Embeddings) umgewandelt. Das sind lange Zahlenreihen, die die Bedeutung eines Wortes oder Satzes in einem mathematischen Raum repräsentieren.

Stellt ein Mitarbeitender eine Frage, wird auch diese Frage in einen Vektor umgewandelt und das System durchsucht die Vektordatenbank nach inhaltlich ähnlichen Informationen. Die gefundenen Informationen werden anschließend zusammen mit der ursprünglichen Frage an das Sprachmodell übergeben. Auf dieser Grundlage formuliert das Modell eine Antwort. Ergänzend können klassische Suchmechanismen und strukturierte Filter, beispielsweise nach Maschinentyp, Dokumentenart oder Erstellungsdatum, genutzt werden. So verringert dieser Ansatz das Risiko fehlerhafter oder frei erfundener Antworten.

Grundlage für zukunftsfähiges Wissensmanagement

Der konkrete Fahrplan für die spätere Einführung sieht vor, zunächst durch kurzfristige Maßnahmen den Umgang mit dem bestehenden Wiki zu erleichtern. Dazu zählen unter anderem verbesserte Vorlagen, Dropdown-Listen, Pflichtfelder sowie klarere Regeln für die Dokumentation. Außerdem sollen Mitarbeitende feste Zeitfenster für die Wissenspflege erhalten.

Im nächsten Schritt steht die Aufbereitung der Daten, das Aufsetzen der Vektordatenbank sowie die Entwicklung eines ersten Prototyps im Fokus. Anschließend können die technische Integration in die bestehende IT-Landschaft und die Anbindung des ERP-Systems erfolgen. Langfristig ist vorgesehen, die Lösung um mobile Anwendungen, weitere Wissensquellen und zusätzliche Funktionen auszubauen.

„Für die Firma Dorst bedeutet das, dass man mit einem initialen relativ hohen Aufwand ein langfristig sehr stabiles Modell aufbauen kann, das auch stetig erweitert werden kann und sich so an den täglichen Bedarf und an wechselnde Anforderungen anpassen lässt.“

Florian Spiegel, Wissenschaftlicher Mitarbeiter im Mittelstand-Digital Zentrum Augsburg

Das Unternehmen hat nun ein praxisnahes Konzept, das vorhandenes Expertenwissen stärker vernetzen und Suchaufwände reduzieren kann. Gleichzeitig wurde deutlich, dass eine erfolgreiche KI-Lösung vor allem auf einer guten Datenbasis und klaren Prozessen aufbaut. Vor allem für kleine und mittlere Unternehmen ist dies entscheidend, denn mit einem KI-gestützten Wissensmanagement können Mitarbeitende entlastet werden.

Video zum Projekt

Die Zukunft der Wertschöpfung ist digital, vernetzt und datengetrieben. Gerade kleine und mittlere Unternehmen (KMU) stehen heute vor der Herausforderung, ihre Wettbewerbsfähigkeit in einem dynamischen Marktumfeld zu sichern und gleichzeitig die Chancen der Digitalisierung gezielt zu nutzen. Künstliche Intelligenz bietet dabei enormes Potenzial, von effizienteren Prozessen über resilientere Lieferketten bis hin zu neuen Geschäftsmodellen. Doch wie gelingt der erfolgreiche Einsatz von KI im Mittelstand? Welche Voraussetzungen müssen Unternehmen schaffen, um KI nachhaltig zu nutzen? Und wie entstehen resiliente Wertschöpfungsnetzwerke, die auch zukünftigen Herausforderungen standhalten?

Beim 2. WertNetzWerke Summit des Mittelstand-Digital Zentrums WertNetzWerke am Fraunhofer IIS in Nürnberg stehen diese und viele weitere Fragen stehen im Mittelpunkt.

Den Link zur kostenfreien Anmeldung und weitere Infos finden Sie hier: WertNetzWerke Summit 2026

Das könnte Sie auch interessieren

Mehr erfahren
PraxisbeispieleProjekte
Mit ML schneller zum Angebot – Preisprognose für Kennzeichnungslösungen

Eine schnelle und fundierte Preisermittlung für individuell gefertigte Produkte kann eine große ...

Mehr erfahren

Mehr erfahren
PraxisbeispieleProjekte
KI-gestütztes Wissensmanagement beim Sondermaschinenbauer

Jeden Tag entstehen in Unternehmen wertvolle Informationen – sei es bei Serviceeinsätzen, ...

Mehr erfahren

Mehr erfahren
Information
Digitaler Produktpass – wie KMU profitieren können

Der Digitale Produktpass (DPP) soll umfassende Informationen über Produkte während ihres gesamten Lebenszyklus ...

Mehr erfahren

Mehr erfahren
PotenzialanalysenPraxisbeispieleProjekte
In einer analogen Druckbranche zum digitalen Geschäftsmodell

Die Mertinger SIGEL GmbH mit ca. 210 Mitarbeitenden aus der Druckbranche bietet eine breite Produktpalette, darunter ...

Mehr erfahren

Mehr erfahren
PotenzialanalysenPraxisbeispiele
Interview über Digitalisierung im Kleinstunternehmen – Offenheit und Neugier machen es möglich

Eine Dreherei mit fünf Mitarbeitenden hat ihren Produktionsprozess nahezu vollständig digitalisiert, aber ...

Mehr erfahren

Mehr erfahren
PotenzialanalysenPraxisbeispiele
Energiemanagement bei großer Anlagenvielfalt im Prototypenbau

Die ModellTechnik Rapid Prototyping GmbH mit ca. 190 Mitarbeitenden in Thüringen fertigt Prototypen für ...

Mehr erfahren

Mehr erfahren
Information
Maschinelles Lernen in der Produktionsplanung

Die Produktionsplanung und -steuerung (PPS) hat das Ziel für eine hohe Auslastung und geringe Bestände zu sorgen, ...

Mehr erfahren

Mehr erfahren
Information
Bedeutung des Datenbestands für erfolgreiche KI-Projekte in KMU

Sie möchten in Ihrem Unternehmen KI-Methoden einsetzen? Dann sollten Sie zuerst Ihren Datenbestand in den Blick ...

Mehr erfahren

Mehr erfahren
Lab TourVeranstaltung
Automatisierung bei der Lab-Tour am TZ PULS

Unter dem Themenschwerpunkt „Intralogistik der Zukunft – Lösungsansätze für den Fachkräftemangel“ fand am 12. ...

Mehr erfahren

Mehr erfahren
PraxisbeispieleProjekte
KI‑basierte Lieferscheinverarbeitung beim Medizingerätehersteller

Täglich treffen im Wareneingang unterschiedliche Lieferungen ein und jede bringt ihre eigenen ...

Mehr erfahren

Mehr erfahren
Information
Wenn Roboter sehen lernen – Bilderkennung und Sensorik in der autonomen Intralogistik

Autonome Stapler, mobile Roboter und erste humanoide Systeme übernehmen im Lager zunehmend ...

Mehr erfahren