
Autonome Stapler, mobile Roboter und erste humanoide Systeme übernehmen im Lager zunehmend Aufgaben, die bisher Menschen vorbehalten waren. Voraussetzung dafür ist, dass sie ihre Umgebung zuverlässig erfassen und interpretieren können. Doch wie funktioniert maschinelles Sehen, welche Möglichkeiten eröffnet KI und wo liegen die Grenzen im industriellen Einsatz?
Umgebungswahrnehmung für Roboter
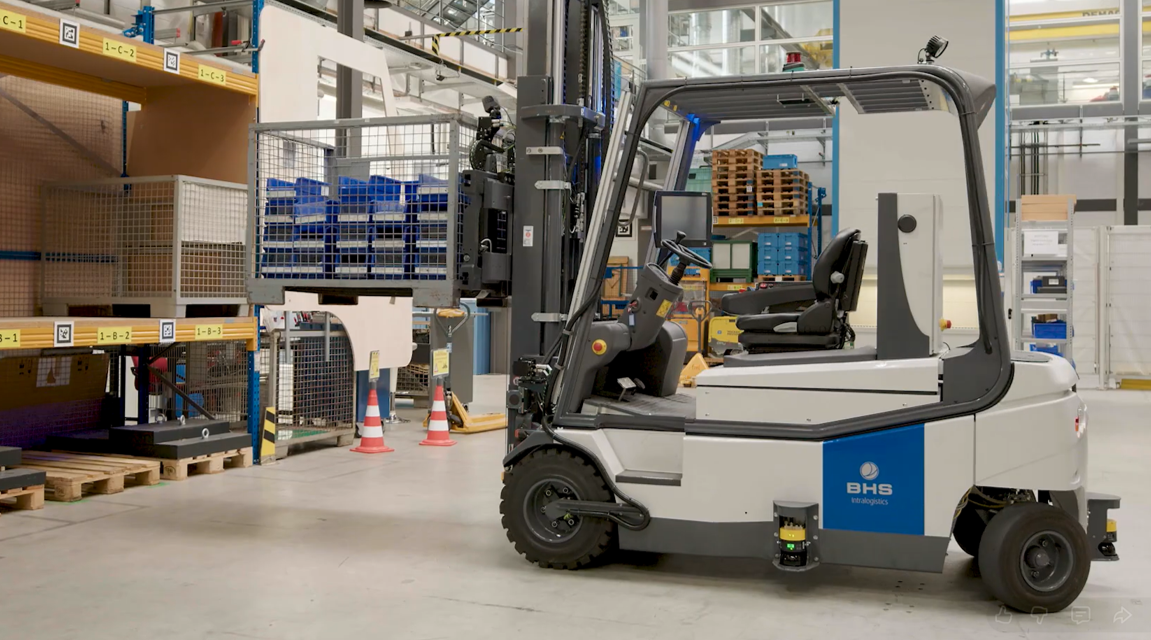
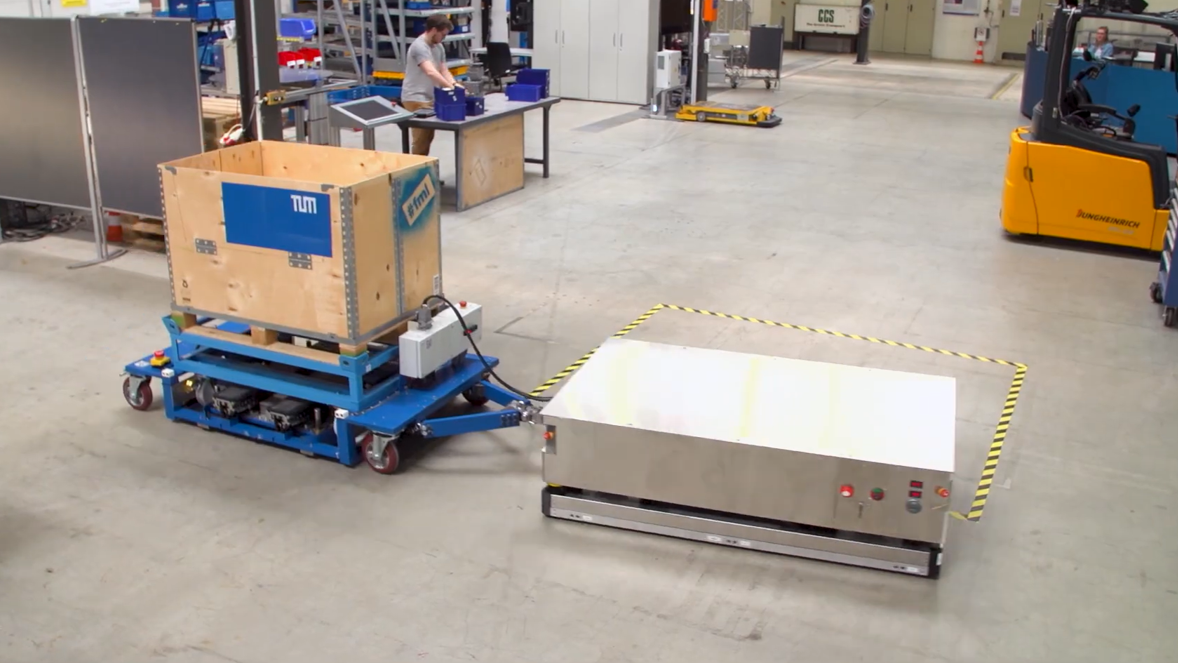
In der Intralogistik arbeiten autonome Gabelstapler, fahrerlose Transportfahrzeuge, mobile Roboter und kollaborierende Roboter zunehmend im selben Raum wie Menschen. Damit sie sich in einer solchen Umgebung sicher und zuverlässig bewegen, müssen sie mehrere grundlegende Aufgaben gleichzeitig beherrschen. Ein Fahrzeug navigiert durch Gänge und Hallenbereiche und bestimmt dabei fortlaufend die eigene Position. Es erkennt Ladungsträger, Regale und Hindernisse und unterscheidet sie von Personen, die sich im Fahrweg aufhalten. Am Ziel kommt es schließlich darauf an, Lasten millimetergenau aufzunehmen und abzusetzen. Grundlage für all diese Fähigkeiten ist eine Sensorik, die die Umgebung ohne Unterbrechung erfasst und dem System ein aktuelles Bild der Situation liefert.
Klassische Bildverarbeitung
Klassische Bildverarbeitung kombiniert Kamera, Beleuchtung und Optik mit einer regelbasierten Auswertung. Das System extrahiert definierte Bildmerkmale und leitet daraus Entscheidungen ab. Ein Beispiel ist die Kantenerkennung nach Canny, die Konturen anhand von Helligkeitsübergängen identifiziert. Der Ansatz ist besonders geeignet, wenn Objekte unter kontrollierten Bedingungen erscheinen. Im Lager erschweren wechselnde Lichtverhältnisse, Verdeckungen und variierende Objektpositionen eine zuverlässige Erkennung. Je weniger sich eine Aufgabe durch feste Regeln beschreiben lässt, desto interessanter werden lernende Verfahren.
KI-basiertes Erkennen
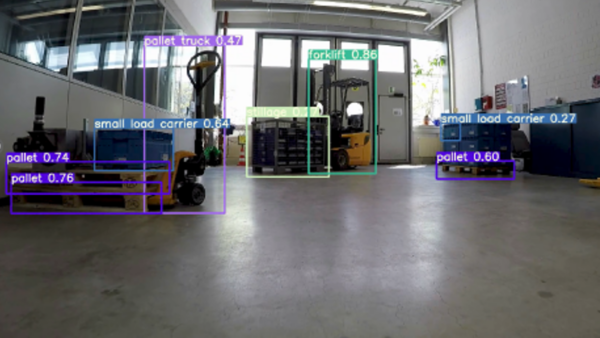
KI-basierte Bilderkennung verfolgt einen grundlegend anderen Ansatz als die klassische Bildverarbeitung. Anstatt Merkmale und Entscheidungsregeln von Hand festzulegen, lernt ein neuronales Netz selbstständig, welche Bildeigenschaften für die Erkennung eines Objekts relevant sind. Den Ausgangspunkt bildet ein Datensatz aus Bildern, in denen die gesuchten Objekte markiert und mit einer Bezeichnung versehen sind. Dieser Schritt wird als Annotation bezeichnet und bestimmt maßgeblich die spätere Erkennungsqualität. Mit den annotierten Bildern wird anschließend ein Modell trainiert, etwa aus der verbreiteten YOLO-Familie (YOLO: You Only Look Once). Das Modell passt dabei seine internen Parameter schrittweise so an, dass es die markierten Objekte immer zuverlässiger findet. Nach Abschluss des Trainings läuft es direkt auf der Recheneinheit des Fahrzeugs. Dort erkennt es Paletten, Behälter oder andere Stapler in Echtzeit, auch bei wechselnder Beleuchtung und unterschiedlichen Perspektiven, und liefert die Information unmittelbar an die Fahrzeugsteuerung.
Multimodale Wahrnehmung
Für die Umgebungswahrnehmung existieren eine Vielzahl von Sensortypen, wobei jeder einen anderen Ausschnitt der Wirklichkeit wahrnimmt.
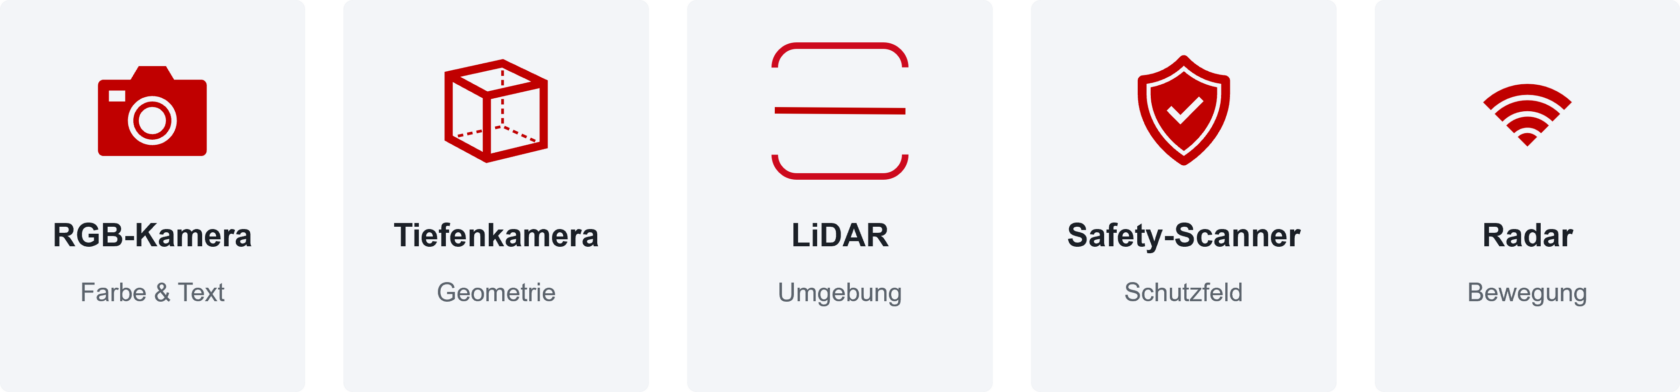
Die RGB-Kamera liefert Farbinformationen und macht Beschriftungen, Etiketten oder Barcodes lesbar. Eine Tiefenkamera ergänzt das Bild um räumliche Information und erlaubt es, die Geometrie von Objekten zu bestimmen. LiDAR (Light Detection and Ranging) tastet die Umgebung mit Laserstrahlen ab und erzeugt ein dreidimensionales Abbild der Umgebung, das vor allem für Navigation und Lokalisierung genutzt wird. Der Safety-Scanner überwacht ein definiertes Schutzfeld um das Fahrzeug und löst bei einem Eingriff eine sicherheitsgerichtete Reaktion aus. Radar wiederum erkennt Bewegungen auch unter Bedingungen, in denen optische Sensoren an ihre Grenzen stoßen, etwa bei Staub oder schlechter Sicht. Keiner dieser Sensoren deckt allein alle Anforderungen ab. Erst die Kombination mehrerer Sensoren gleicht die Schwächen der einzelnen Systeme aus und ermöglicht eine robuste Wahrnehmung.
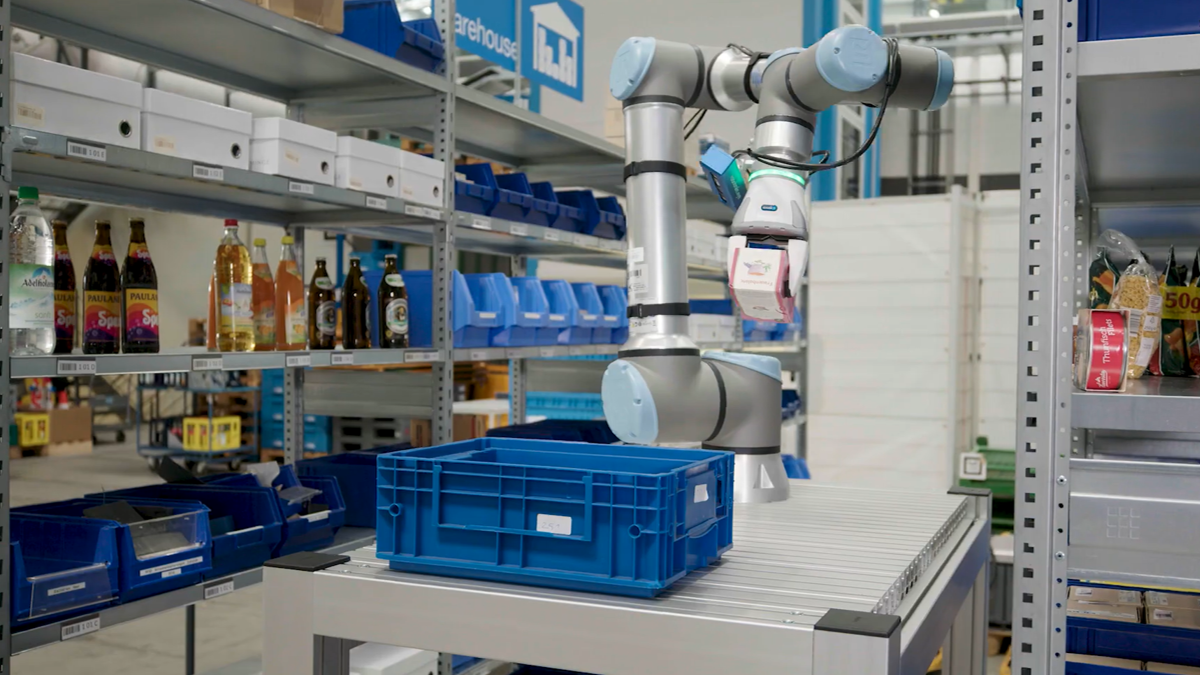
Welche Kombination sinnvoll ist, ergibt sich aus dem jeweiligen Prozess. In der Pickrobotik ermöglicht das Zusammenspiel von RGB- und Tiefendaten, Objekte zu erkennen und ihre Lage so genau zu bestimmen, dass ein Greifer sie sicher aufnehmen kann. Mobile Roboter verbinden LiDAR und Kamera, um Hindernisse zuverlässig zu erkennen und ihren Weg durch die Halle eigenständig zu planen. Bei humanoiden und kollaborierenden Robotern tritt zusätzlich die Verarbeitung von Sprache hinzu. Modelle, die Bild und Text gemeinsam verarbeiten, erlauben es diesen Systemen, Anweisungen von Menschen zu verstehen, Situationen im Zusammenhang zu interpretieren und so enger mit Beschäftigten zusammenzuarbeiten.
Bild und Sprache für flexible Objekterkennung
Ein klassisches KI-Modell zur Objekterkennung kann nur die Klassen erkennen, auf die es zuvor trainiert wurde, beispielsweise Paletten, Kleinladungsträger oder Gitterboxen. Taucht im Prozess ein neues Objekt auf, muss das KI-Modell wieder neu trainiert werden. Zunächst müssen geeignete Bilder gesammelt und manuell annotiert werden, bevor das Netz mit dem erweiterten Datensatz neu trainiert werden kann. Gerade in Lagern mit wechselndem Sortiment und vielfältigen Ladungsträgern wird dieser Kreislauf schnell zum Engpass.
Vision-Language-Modelle verfolgen einen anderen Ansatz. Ein Bild-Encoder zerlegt das Bild in einzelne Bildausschnitte, sogenannte Bild-Tokens, während ein Tokenizer die textuelle Anfrage in Wort-Tokens überführt. Ein Sprachmodell verarbeitet anschließend beide Arten von Tokens gemeinsam und stellt so einen Bezug zwischen Bildinhalt und Sprache her. Dadurch lassen sich Objekte über eine einfache Beschreibung in natürlicher Sprache ansprechen, ohne dass dafür ein eigenes Training erforderlich ist.
Praxisbeispiel – Prompt statt Training
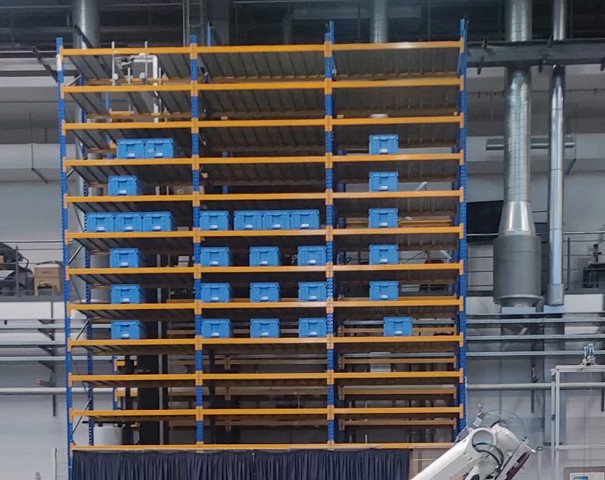
Ausgangslage: In einem Regal sollen Behälter erkannt werden, für die es keinen trainierten Datensatz gibt.
Vorgehen und Ergebnis: Grounding DINO (Vision-Language-Modell) erhält nur den Prompt „blue boxes“ und markiert die blauen Behälter, ganz ohne Annotation und Neutraining.
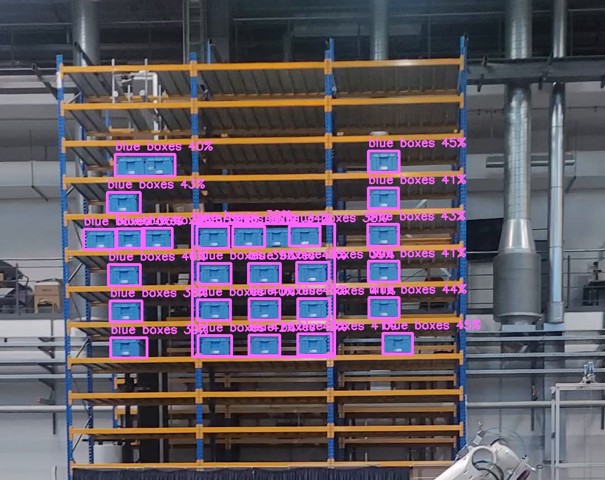
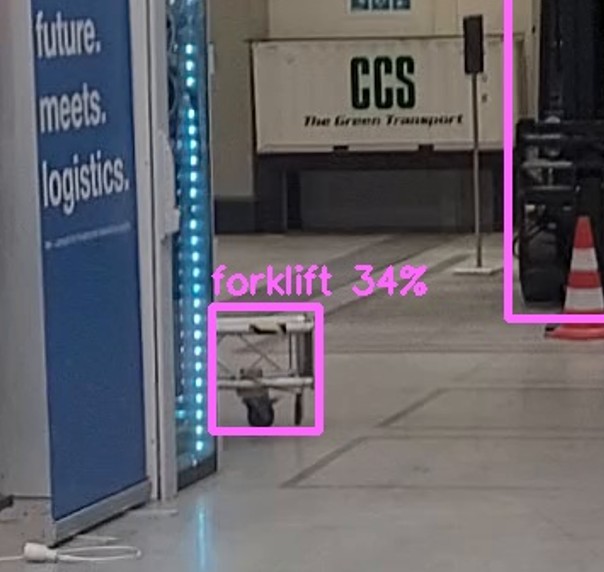
Grenze: Beim Prompt „Forklift“ werden die Stapler gefunden, aber auch ein kleiner Wagen mit 34 % Konfidenz. Schwellwerte und Validierung bleiben nötig.
Physical AI als nächste Entwicklungsstufe
Unter dem Begriff Physical AI (dt. Physische KI) wird die nächste Entwicklungsstufe zusammengefasst, in der KI nicht nur Daten auswertet, sondern in der realen Welt wahrnimmt, entscheidet und handelt. Sehen, Verstehen und Handeln greifen dabei unmittelbar ineinander. Kameras und weitere Sensoren erfassen die Umgebung, ein Modell interpretiert die Szene im Zusammenhang und leitet daraus eine Handlung ab, die der Roboter anschließend ausführt. Der entscheidende Unterschied zu bisherigen Systemen liegt darin, dass Aufgaben nicht mehr im Detail programmiert werden müssen. Eine Anweisung wie „Nimm die unbeschädigte Palette aus Reihe 3 auf.“ verlangt vom System, die richtige Reihe zu finden, mehrere Paletten zu unterscheiden, deren Zustand zu beurteilen und die passende auszuwählen. Solche Anweisungen in natürlicher Sprache werden damit direkt umsetzbar und eröffnen neue Möglichkeiten für flexible Abläufe im Lager.
Fazit – Mehr Autonomie braucht verlässliche Wahrnehmung
Roboter in der Intralogistik lernen zunehmend, Situationen zu bewerten, statt nur vorab festgelegte Regeln abzuarbeiten. Die technische Machbarkeit bedeutet jedoch noch keine industrielle Verlässlichkeit. Wechselndes Licht, Verschmutzung, Verdeckungen und unbekannte Objekte stellen hohe Anforderungen an die Robustheit der Systeme. Ebenso offen ist vielfach die Frage, wie zuverlässig die Aussage eines Modells im Einzelfall ist und wie sich das nachweisen lässt. Nutzbar ist KI-basierte Wahrnehmung heute deshalb vor allem als Assistenzfunktion, die parallel zur bestehenden Sicherheitskette arbeitet. Je selbstständiger Roboter künftig handeln sollen, desto mehr entscheidet ihre Wahrnehmung darüber, welche Aufgaben sie sicher und wirtschaftlich übernehmen können.